はじめに
こんにちは! 医師Web開発チームで SRE を担当している藤田です。
気づけば新卒2年目となっており、時間はあっという間だなとしみじみ思います。
さて、私たちのチームでは、医師向けのキャリア支援サービスを運用しています。
監視は長らく CloudWatch で行っていましたが、クエリのパフォーマンス劣化に起因する障害がありました。復旧に時間を要してしまい、原因としてはオブザーバビリティが整っておらず、どこが原因なのかの切り分けが難しかったからです。
これをきっかけに、監視の仕組みそのものを Datadog で作り直しました。今回はその話をご紹介させていただきます。
以前の課題
皆さんの中には、アラートのオオカミ少年化に心当たりがある方がいると思います。
私たちの AWS リソース監視も同じことが起こっており、正常に動いているリソースのアラートが1日30件以上飛んできていました。結果、ノイズが多すぎて、確認作業に時間を費やしていました。
そんな状況なので、いざ障害が起きても、頼れるのは CloudWatchのログと、あちこちに散らばったメトリクスだけでした。結果、ログとメトリクスの付き合わせを行うのに時間を要してしまい、原因究明が遅くなってしまっておりました。
さらに、エンドポイントごとのレイテンシも取れていなかったため、こちらから遅いエンドポイントに手を入れることができず、いざ改善しようにも特定だけで一苦労、という状況でした。
Datadog を導入するにあたって
そもそも Datadog で何ができるのかを、先に整理しておきます。
- Datadog は、ログ・メトリクス・トレースという3つの観点を1つのツールで扱えます。さらに最近は Bits AI によって、集めたデータをもとに障害の根本原因の特定やトリアージまで任せられるようになりました。
導入に必要な設定は、大きく2つです。
-
AWS インテグレーション
-
Datadog が AWS API を叩けるように AssumeRole を許可するもので、RDS や ECS のメトリクスを取り込むために必要
-
Datadog Agent をサイドカーで置く
-
こちらはログやトレースをアプリ側から Datadog へ送るために必要
では、私が行った導入手順をご紹介します。
Phase 1: アプリ側の下ごしらえ
ログを JSON 構造化 & 要らないログを止める
まず、ライブラリを用いてログをJSON に変えます。調査時にJSON形式で検索できたほうが、認識性が高まるからです。また、人間や生成AIによる調査とも相性が良いため一石二鳥です。
出力するフィールドは次のように決めました。
- @timestamp / message / level / logger_name / thread_name — 基本項目。エンコーダが自動付与
- service — サービス名。
- env — 環境名(qa / prod)。
- version — git コミットハッシュ。
- dd.trace_id / dd.span_id — トレース ID / スパン ID。Phase 2 で dd-java-agent が自動セット
- stack_trace — スタックトレース。例外発生時に自動付与
-
{
"@timestamp": "2026-04-15T16:17:38.936+09:00",
"message": "...",
"logger_name": "com.example.infrastructure.SomeRepositoryImpl",
"thread_name": "xxxxxxxxxx",
"level": "INFO",
"version": "5582c6e",
"service": "xxxxxxx-api",
"env": "prod"
}
また、構造化と同時に、ノイズを削りました。
削った対象は以下です。
- ヘルスチェック関連のログ
- 特定のライブラリのwarnログレベル未満
- ORM の SQL ログ
Phase 2: Datadog Agent をサイドカーで置く
ECS タスク内にサイドカーコンテナを2つ追加します。
- datadog-agent — APM トレース受信 / メトリクス収集 / ログ送信
- log-router — FireLens によるログ振り分け
アプリコンテナのログドライバーを `awslogs` → `awsfirelens` に変更し、Fluent Bit で振り分けます。ここで、ログレベルでのログ選別を行っております。
具体的な設定項目
datadog-agent
-
"environmentFiles": [
{ "type": "s3", "value": "arn:xxxxxxxxxxx.xxxxx.env" }
],
"secrets": [
{ "name": "DD_API_KEY", "valueFrom": "arn:...:xxxxxx.xxxx" }
]
ECS_FARGATE や DD_APM_ENABLED といったエージェント設定は、タスク定義に書かず S3 の .env に外出ししました。設定変更のたびにタスク定義のリビジョンを切りたくなかったためです。
log_router(Fluent Bit)
-
DD_HOST http-intake.logs.datadoghq.com
DD_API_KEY Secrets Manager経由
DD_SERVICE hogehoge
DD_ENV prod
DD_SOURCE ecs
DD_TAGS team:xxxx
DD_MESSAGE_KEY msg
appコンテナ ― トレーサ(dd-trace)の挙動
-
DD_TRACE_SAMPLE_RATE 0.X ← トレースの 100 * X %だけ送信(コスト調整)
DD_PROFILING_ENABLED true ← Continuous Profiler
DD_ENV prod
DD_SERVICE hogehoge

`dd-java-agent` を仕込む
Dockerfile に Java Agent を入れ、トレースのサンプリングレートなどを設定します。
ECSのタスク定義に環境変数を設定し、Dockerfile内で参照する形です。
-
ADD https://.../dd-java-agent-${DD_JAVA_AGENT_VERSION}.jar /app/xxxxx.jar
CMD java \
"-javaagent:/app/dd-java-agent.jar" \
"-Ddd.service=xxxxxxxxx" \
"-Ddd.env=${DD_ENV:-production}" \
"-Ddd.version=${DD_VERSION:-unknown}" \
"-Ddd.logs.injection=true" \
"-Ddd.trace.resource.exclude=.*healthcheck.*" \
-jar build/xxxxxxxxx.jar
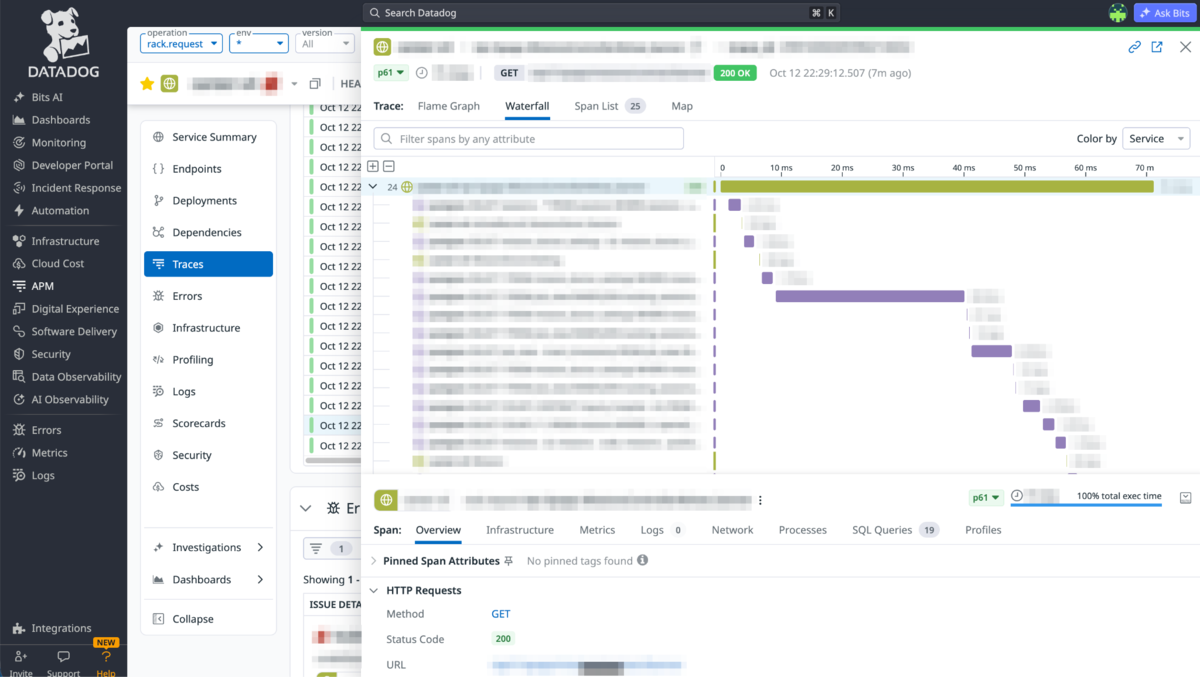
これにより、APMが使えるようになります。
APM導入後
APMではいろいろなことを見ることができ、サービスの総リクエスト数から依存先サービスの情報まで、幅広く情報が集まっています。私は大体この画面に訪れることが多いです笑。
※2 参考画面
Phase 3: AWS インテグレーションの設定
AWS Integration 側は Terraform で IAM ロールを作り、STS経由でDatadog の AWS アカウントからの AssumeRole を許可します。

なお AWS Integration 自体には Datadog 側の追加課金は発生しませんが、見落としやすいのが AWS 側の CloudWatch API 料金です。
Datadog は GetMetricData を定期的にポーリングするため、その分が AWS の請求に乗ります。デフォルトの10分間隔を1分間隔に詰めると呼び出し回数が10倍になり、料金もそのまま10倍になります。「メトリクスの粒度を上げたい」ということがあると思いますが、料金とのトレードオフになります。
Phase 4: アラート(Datadog Monitor)の設定
トレースとメトリクスが集まり始めたら、次は「何を、どの閾値で鳴らすか」です。
ここで解決したかったもう一つの課題が、アラートのオオカミ少年化でした。既存の CloudWatch Alarms は鳴りすぎていて、誰も真剣に見ていない状態になっていました。
閾値の設定
アラートレベルを設定しました。
- p1 今すぐに対応開始した方がいいアラート
- p2 頭の中に入れておくべきアラート
p1とp2の違いに関しては、ユーザー体験に影響が出ているかを基準に設定しております。
また、APM のレイテンシ監視で、p50 / p95 / p99 をどう使い分けるかも定義しました。
- p50 — 半分のリクエストがこの時間以内。「普通のユーザー」の体験で、p50 が動いたらサービス全体が壊れているので確実に対応が必要
- p95 — 95% がこの時間以内。一部リクエストの劣化。p50 より先に兆候が出る。そこまで緊急ではない。
- p99 — 99% がこの時間以内。テールレイテンシ。最も早く予兆が出る。我々は設定していません。
Datadog Monitor のTerraform化
最終的に、本番環境で 65本の Monitor を運用しています。先ほどの通り、重要度は
P1 = 即対応 / P2 = 要確認 の2段階にしました。
主要なものを抜粋します。
アプリの応答品質
- レイテンシ p50(P1) — 全ユーザーに影響する全体的な遅延
- レイテンシ p95(P2) — 一部ユーザーの遅延(早期兆候)
- 500 エラー率(P1) — サーバエラーの急増
- 全体エラー率(P1) — DB・外部 API 含む全体のエラー増。
閾値そのものは仮値として設定し、2週間ほどの過去データを見ながら調整しました。
※参考にした本
CloudWatch アラームの撤去
Datadog に移行できたものから、CloudWatch Alarms を消していきました。
Phase 5: ダッシュボードの作成
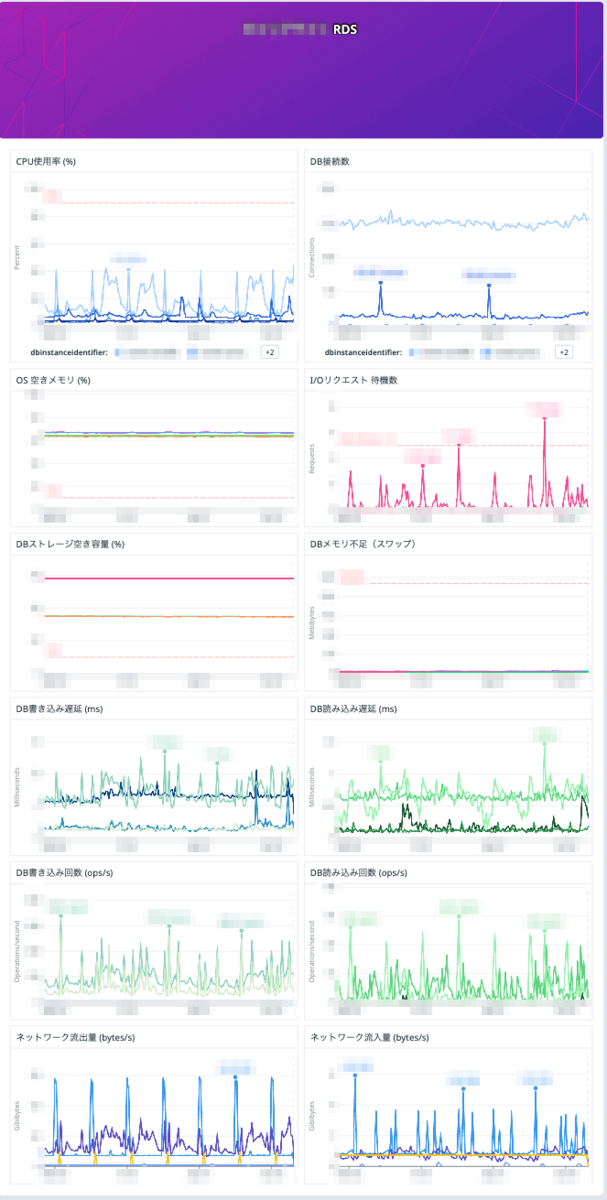
我々のチームは、サービスを7個以上持っているので、ダッシュボードを1ページで管理できるようにしました。
これにより普段のSREチームミーティングでのAWSリソースの監視がだいぶ楽になりました。
※参考画面
Phase 6: アラート調査を自動化する
ここまでで「予兆に気づける」状態にはなりました。ただし、気づいた後に Datadog を開いて調べるという作業は残っています。Phase 6 では、ここを削りにいきました。
使ったのは Datadog Workflow Automation と Bits AI Investigation です。
Bits AI Investigationとは
Bits Investigation は、アラートを受け取るとまずモニターのメッセージ・過去の同じ調査を読んでコンテキストを作り、そこから根本原因の候補を複数立てます。
その後、Datadogに集約しているログ・メトリクス・トレースなどの情報から、検証中の仮説に関係するデータだけを狙って問い合わせ、validated / invalidated / inconclusive に分類します。
裏付けが取れた仮説だけをさらに深く掘り、取れなかった枝は切る。これを繰り返して、根拠つきのレポートにたどり着きます。

Datadog Workflow Automation + Bits AI
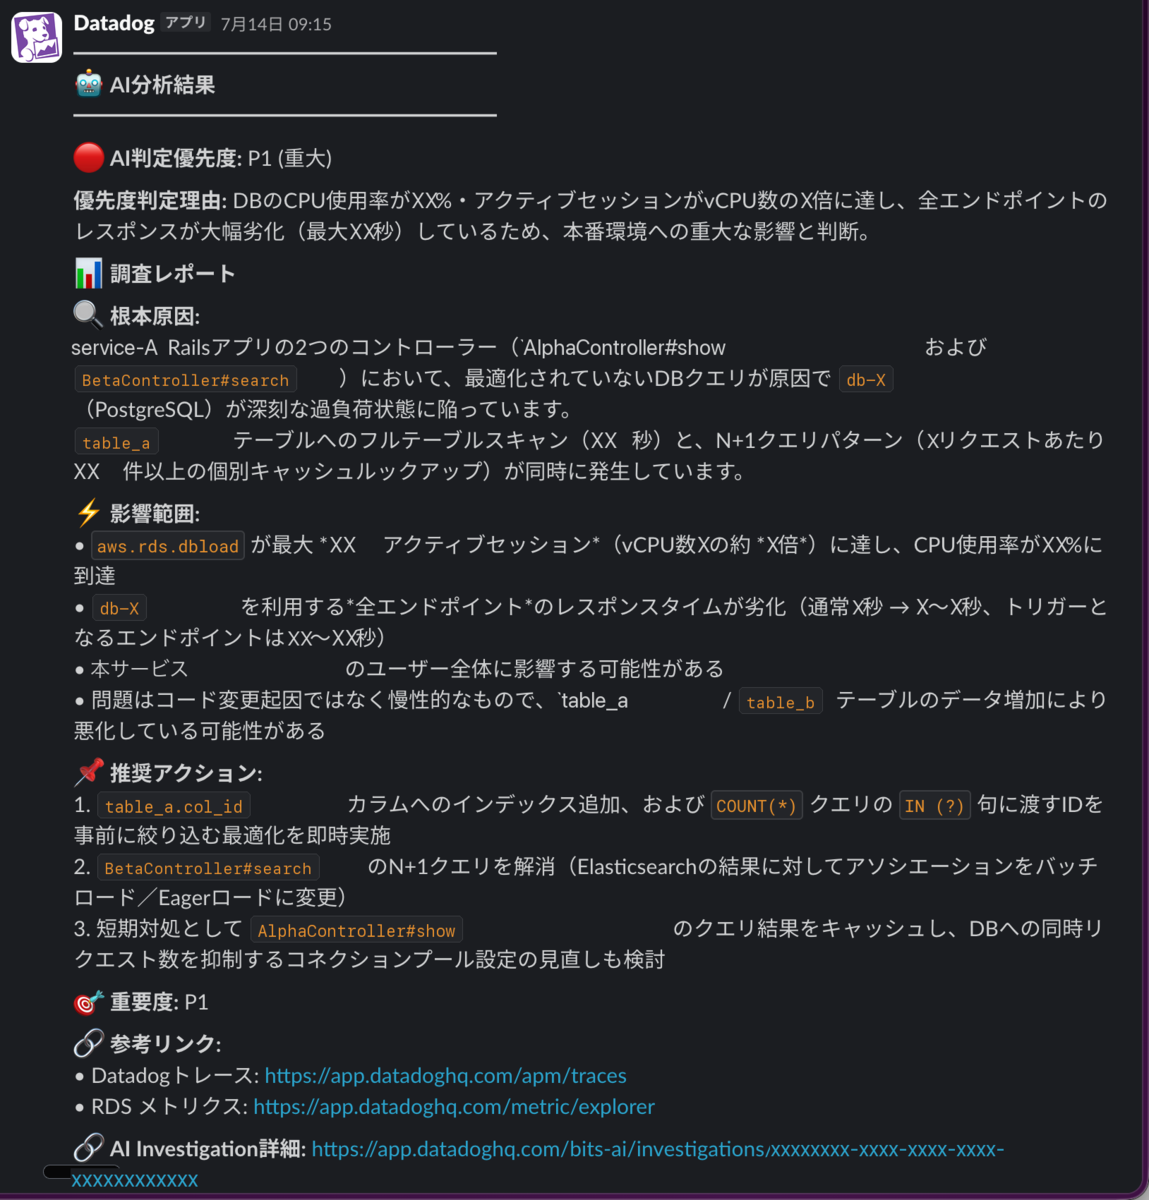
Datadog Workflow Automation は、先ほど設定したDatadog Monitorを起点に、ワークフローを起動してBits AIの調査や、Slackに通知を送ったりなどの処理を行うことができます。
今回は、これを用いて自動調査のフローを作成していきます。
上記のフローとしては以下の通りとなっております。
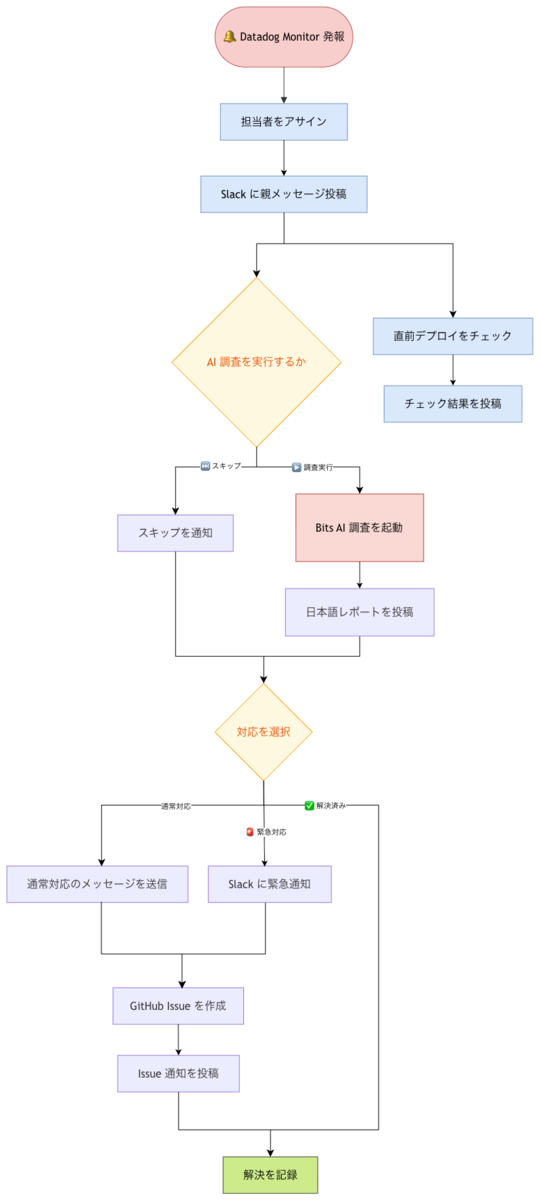
使う側がやることは、Slack でボタンを押すだけです。基本的に Datadog を開かなくても完結します。
設計で意識したのは、次の2点です。
AI 調査は自動起動しない
- 「実行する / スキップ」をボタンで選べます。既知のアラートや誤検知で毎回調査が走ると、今度は調査レポート自体がノイズになります。アラートのオオカミ少年化を解決しにきたのに、調査結果で新しいオオカミ少年を作っても意味がありません。
デプロイクイックチェックと AI 調査を分離して並列で動かす
- アラートと同時に「直前に何かデプロイされていないか」だけを先に返します。原因がデプロイなら、AI 調査を待たずにその場で判断できます。実際、障害の原因として直前のデプロイが関係している可能性が高いからです。
※フロー選択画面
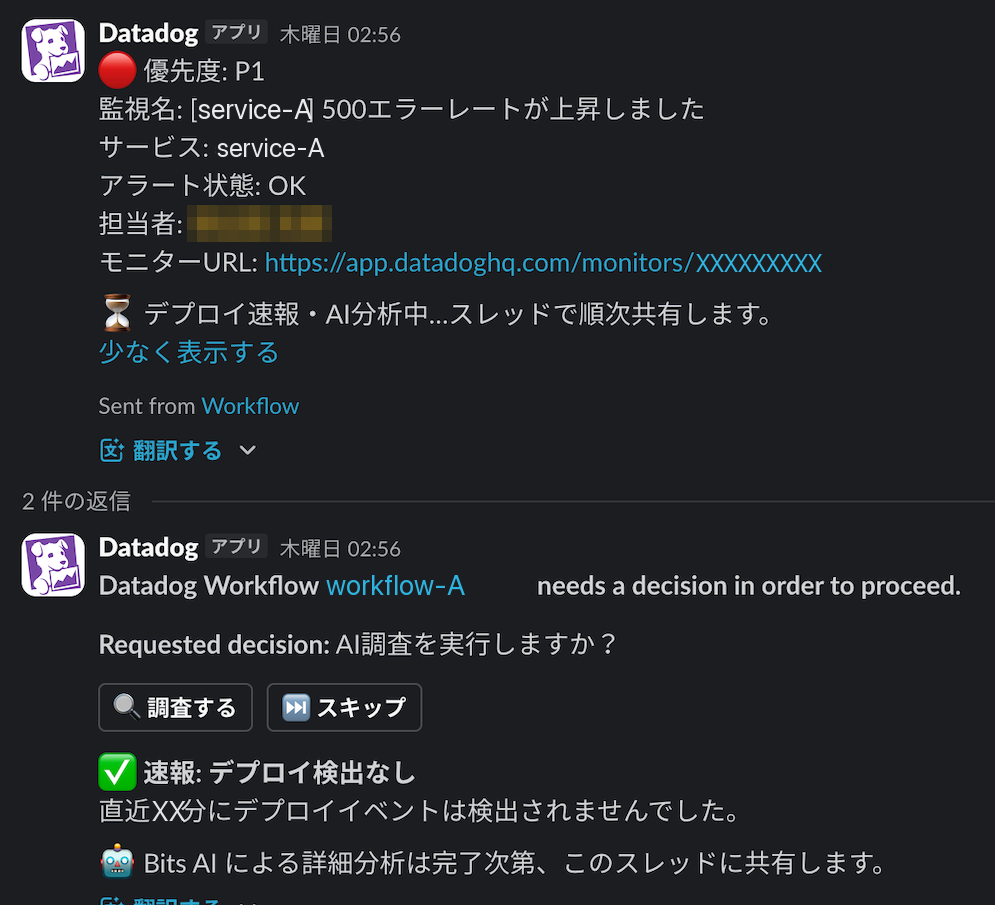
※レポート画面 (下記画像はテストで出力されたものです)
Phase 7: AWSリソースの1週間のレポートを出力させる
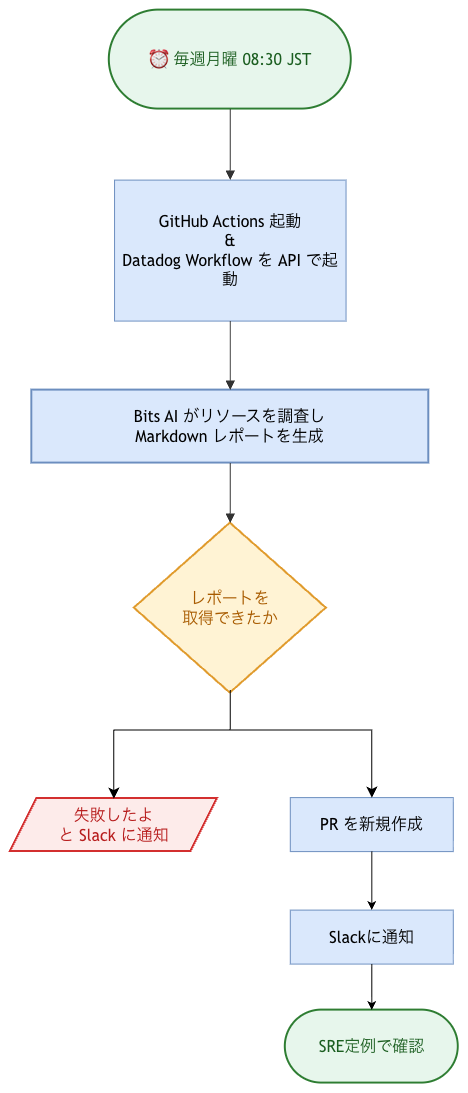
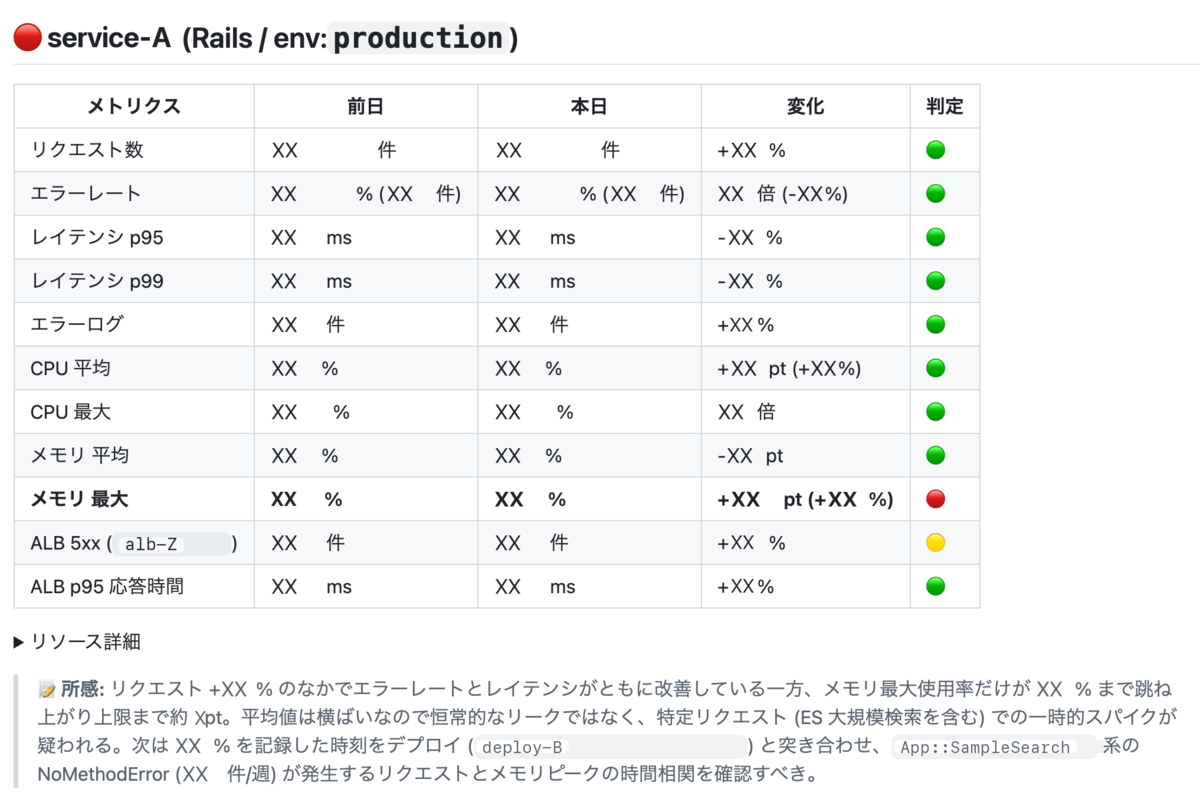
こちらも同じくWorkflow AutomationとBits AIとGitHub Actionsにより、定期的にリソースのレポートを出力させております。
見なければいけないサービスが多く、先週などから大きく変わっていないかなどの監視は依然として見ておきたい部分ではあります。
なので、GitHub ActionsからWorkflow Automationを起動し、定期的にGitHubに調査レポートがPRとして作られるようにしております。
フローとしては、下記の通りです。
これにより、普段SRE定例で確認している工数を削減できました。
※実際のレポート
Datadogを導入して変わったこと
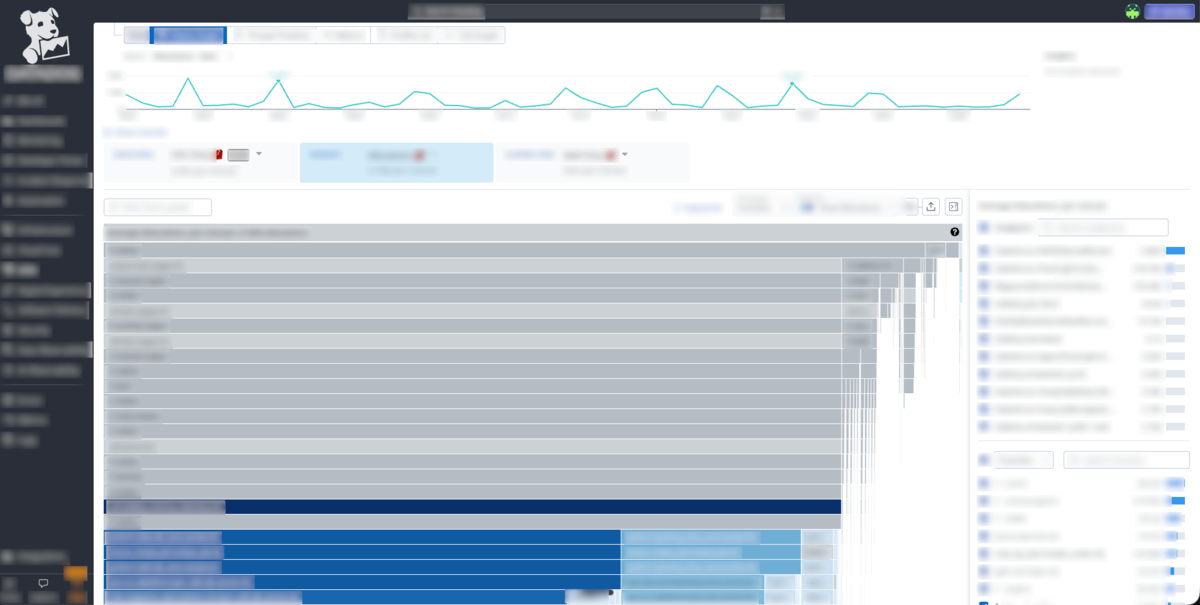
1. 普段のAPM画面や、Datadog Continuous Profilerにより、OOM問題やECSタスクやRDS CPU使用率高負荷問題が起こった際に、関数単位での使用率が可視化され、原因特定を早めることができました。
※2 参考画面(Datadog Continuous Profiler画面)
2. 外部APIやサービス間通信の可視化
今まで調査が困難だったタイムアウトエラーを、サービスの中でのボトルネックとなっていたElasticsearchからのデータ取得部分を発見&改善し、タイムアウトとなっていた処理を改善することができました。
3. エンドポイント単位でのレイテンシーやリクエスト数が可視化され、今まで気づかなかったユーザー体験のボトルネックを改善することができました。
工夫した点・苦労した点
ログをどこまで Datadog に送るか
苦労した点:ログを全部 Datadog に送るとコストが膨らみます。ただ、どこまで絞るべきかは感覚では決められませんでした。
解決方法:まず CloudWatch Logs Insights でログ量を実測しました。その結果を見て、全量は CloudWatch に残し、Datadog には ERROR / WARN だけを送る構成にしています。あわせてヘルスチェックのログと本番の SQL ログも止めました。トレースもサンプリングレートを低めから始めて、段階的に上げています。
アラートを「鳴りすぎない」状態にする
苦労した点:以前は 1 日 30 件以上のアラートが飛んでいました。かといって、閾値を最初から正しく決めることはできません。
解決方法:重要度はユーザー影響を基準に P1 / P2 の 2 段階に分けました。閾値はまず仮の値で入れ、運用しながら調整しています。Monitor は Terraform で管理しているので、変更は PR で残ります。
閾値変更の基準も決めており、1 つの Monitor が 1ヶ月に 5 回以上鳴り、そのうち対応不要なものが半分以上なら、閾値や評価期間を緩めます。逆に、アラートより先に問い合わせや目視で障害に気づいた場合は、閾値を締めるか、新たな観点でアラートを追加します。
なお、深夜などリクエスト数が少ない時間帯は、数件のエラーでもエラー率が跳ね上がり、アラートが鳴りやすくなります。この場合は、「リクエスト数が一定以上」かつ「エラー率が閾値超え」を AND 条件で組み合わせた Composite Monitor を使えば、母数が少ないときは鳴らないようにできたりします。
AI 調査を新しいノイズにしない
苦労した点:アラートのたびに AI 調査が走ると、今度は調査レポートがノイズになります。また、Bits AI の調査結果は英語で届くので、チームで読むには少し負担がありました。
解決方法:
- AI 調査は自動では起動せず、Slack のボタンで実行するかどうかを選ぶ
- 直前のデプロイの有無だけを先に返し、AI の結果を待たずに判断できるようにする
- 翻訳エージェントを挟み、日本語のレポートにしてから Slack に投稿する
今後は、下記に取り組んでいきたいと考えています。
- SLI/SLO の策定
- 可用性・レイテンシを定量的に定義し、エラーバジェットを可視化していきたいです。障害の規模を、エンジニアがその場その場で感覚で決めるのをやめたいです。
まとめ
今回、CloudWatch から Datadog への移行を7つのフェーズに分けて進めた取り組みをご紹介しました。
現在では、障害対応にはもちろん、普段のパフォーマンスチューニングや新規実装時の負荷予測など、またブラックボックス化していた既存エンドポイントの可視化など、様々な恩恵を受けています。
まだまだ発展途上ですが、引き続き改善を重ねて、より安定したサービスを提供していけるよう努力していこうと思います。
私たちエムスリーキャリアのチームやエンジニアリンググループに少しでも興味を持っていただけましたら、ぜひ下記の採用ページをご覧ください!
https://career.m3career.com/midcareer/engineer
