AIチャットで社内からの「質問・相談」を約4割減らした話 — 社内依頼受付AIの設計と手応え

エムスリーキャリアで医師領域のSalesforceまわりの開発・運用を担当している後藤です。 今回は、社内から寄せられる問い合わせ・依頼の対応を、AIチャットで構造的に減らしにいった取り組みを紹介します。

エンジニアに寄せられる「社内依頼」の実情

私たちのチームには、営業・マーケティング・お客様センターなど各部署から、Salesforceに関する依頼が日々寄せられます。「この項目はどういう条件で更新されるのか?」という仕様の質問から、権限付与・施設ページのマージといった定型作業、項目追加や自動化などのシステム変更まで、種類も粒度もさまざまです。

直近(2026/6/1〜7/22)の起票データを見ると、内訳はこうなっていました。

レコードタイプ 割合
定型作業 34%
質問・相談 28%
システム変更 28%
不具合・障害 10%

ここで目を引くのは、「質問・相談」と「定型作業」で全体の6割を超えるという点です。この2つは、多くが「過去に誰かが答えた質問」「手順が決まっている作業」であり、本来ならわざわざエンジニアに起票しなくても解決できる余地があります。 しかし従来は、依頼者がSalesforce画面から自力でレコードタイプを選び、白紙のフォームに要件を書いて起票する導線しかありませんでした。

結果として、

  • 調べれば分かる質問がそのまま起票され、エンジニアが調査・回答に時間を割く
  • レコードタイプの選択ミスや情報不足で、起票後に差し戻し・確認のやり取りが発生する

という形で、対応コストが積み上がっていました。 特に「質問・相談」は、Salesforceの仕様確認や操作方法など過去の回答の蓄積で自己解決できる余地が大きいカテゴリでした。

打ち手:入口に「社内依頼受付AI」を置く

そこで「社内依頼相談(AIアシスト)」というAIチャットを作成しました。依頼者はAIチャットに「◯◯が動かない」「◯◯をしたい」と話しかけるだけです。

チャットは次の4つを担います。

  1. ナレッジ・メタデータをその場で検索して回答 — Salesforceナレッジと本番Salesforceメタデータを検索し、その場で答える。ここで解決すれば、そもそも依頼を作らずに済む
  2. 依頼の種類(レコードタイプ)を自動判定 — 会話内容から適切な種類を提案する
  3. 依頼文のドラフトを自動生成 — レコードタイプごとの入力項目に沿って整形。あとは貼って保存するだけ
  4. システム変更依頼は一次チェックも実施 — 「工数に見合う効果があるか」をAIが先に確認し、基準を満たさない場合は修正を促す(差し戻しの削減)

ねらいは以下の2点です。 答えられる問い合わせはその場で答えて起票させない 起票される依頼は質を揃える 前者は問い合わせ総量を、後者は起票後の手戻りを減らしにいく設計です。

仕組み:Salesforce × Dify × GitHub

技術的な構成はシンプルに保ちました。本体はDify上のチャットフローです。
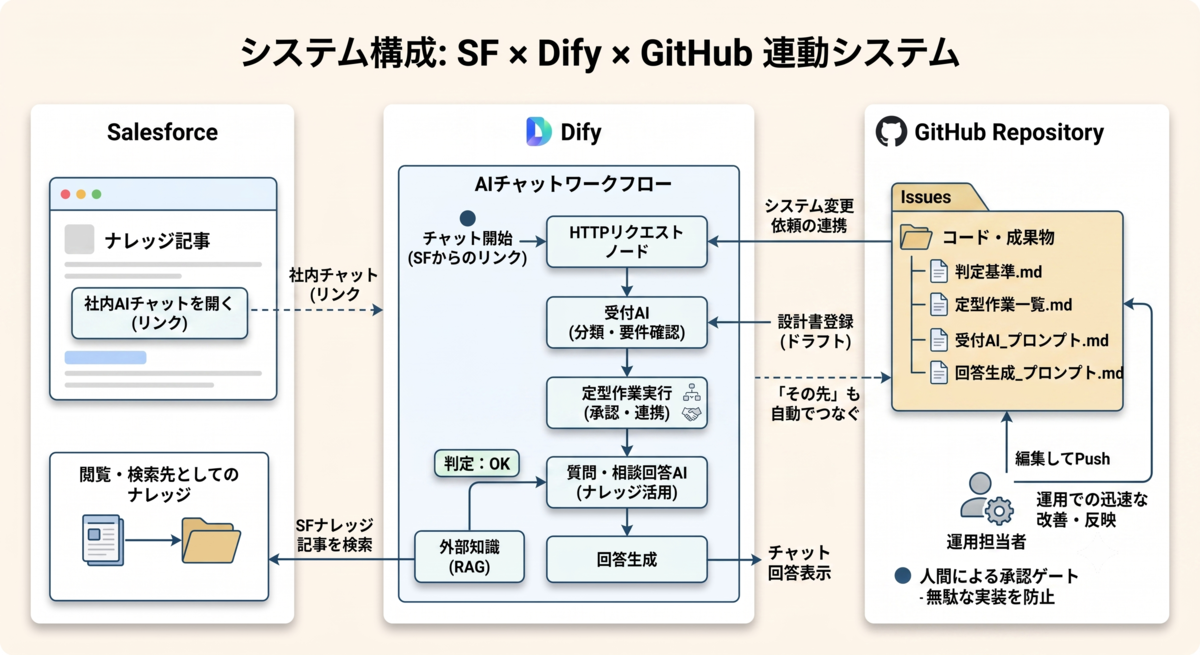
社内依頼受付AIの設計

この構成のポイントは、判定基準・定型作業一覧・受付AIのプロンプトそのものまで、すべてGitHubの.mdファイルとして管理し、チャット実行時にリアルタイムで取得していることです。

最初はプロンプトをワークフロー定義(DSL)に埋め込んでいたのですが、文言を1行直すたびにDSLを再インポートして公開し直す必要がありました。そこで、基準・一覧・プロンプトを.mdに外出しし、DifyのHTTPノードでGitHubから取得する形に変更。運用担当が.mdを編集してpushすれば、Dify側の作業なしで即座にチャットへ反映されるようになりました。 「分類がいまいち」と思ったらその場で基準を書き換えて試せる。この"運用で回せる"状態が、AIチャットを育てていく上で効いています。

質問・相談への回答では、単に社内のナレッジ保管場所を案内するのではなく、調べて分かった中身そのものを回答に書き、根拠にしたナレッジ記事のタイトルを添えるようにしました。依頼者にとっての検索先はあくまでSalesforce上のナレッジであり、内部のファイルパスを見せるのは導線として誤りだからです。

起票の"その先"も自動でつなぐ

さらに、システム変更として起票された依頼は、AIの一次チェックがOKになると、そこからGitHub Issueが自動で作られ、社内の開発エージェントが設計書ドラフトを生成するところまでつながっています。依頼の入口(社内依頼受付AI)から設計の入口までを、人手を挟まずに橋渡しする形です。承認は人間が行い、無駄な実装を防ぐゲートは残しています。

効果:「質問・相談」の起票が約4割減った

導入前後で実際に何が変わったのか、社内依頼の起票データで確認してみました。今回のチャットの主戦場は「①ナレッジ・メタデータ検索でその場で回答する」機能なので、対象を「質問・相談」の起票件数に絞り、リリース日を挟んで前後1ヶ月を比較します。

1日あたりの起票件数で約41%の減少でした。 週次で見ても、導入直前の週をピークに、導入週から減少に転じ、その後は低い水準で安定しています。

もちろん、この減少がすべてチャットの効果だと厳密に証明できるわけではありません(依頼内容の季節性や他の要因も混ざり得ます)。 ですが、リリースのタイミングを境に明確な減少トレンドへ転じ、その後1ヶ月近く低水準が続いているのは、狙っていた「その場で自己解決させて起票させない」導線が機能していると捉えています。

あわせて、起票される依頼文の粒度が揃い、レコードタイプの選択ミスによる差し戻しも減ってきた実感があります。こちらは定性的な手応えの段階ですが、次のフェーズではDify側のログ(会話数・自己解決率・起票への転換率)も取得し、より直接的な効果測定につなげていく予定です。

作ってみて改めて思うのは、AIチャットの価値は「賢いモデルを置くこと」以上に、基準やプロンプトを運用で回せる形にしておくことにあるということでした。 現場の問い合わせは生き物なので、育てられる仕組みかどうかが効いてきます。

「自動化で楽をする」だけでなく、「自動化しても品質を落とさないためのゲートをどこに置くか」という点には特に注意を払いました。 システム変更の一次チェックや最終的な承認工程など、AIに任せるべき領域と人間が責任を持つ領域を明確に分けることが、持続可能な社内AI運用の鍵だと考えています。

おわりに

エムスリーキャリアのエンジニア組織では、こうした社内業務のAI活用を含め、さまざまな取り組みを進めています。少しでも関心を持っていただけた方は、カジュアル面談も受け付けていますので、ぜひお話しさせてください。
https://career.m3career.com/midcareer/engineer

オンプレからサーバーレスへ。バッチサーバーのStep Functions移行。

こんにちは。エンジニアリンググループの吉田です。

私たちのチームでは、オンプレのバッチサーバーで動いているジョブを、クラウドへ移行していく取り組みを進めています。この記事ではこの移行における設計と実行基盤の構築を紹介します。

やったこと

  • cron + Perlによるジョブ制御を、サーバーレス構成に置き換え
  • AWSにジョブの実行基盤を構築し、Terraform / ecspressoでコード化

移行前の構成

長年運用されてきたバッチサーバーは、その長い歴史の中で段階的に機能拡張が重ねられてきました。その結果、言語やジョブ管理の仕組みが幾層にも重なり、現在の構成に至っています。

  • サーバー: オンプレ
  • 言語: Rubyを中心にPHP・Perl・シェルスクリプトが混在。メール送信は共通のPerlスクリプト
  • ジョブの制御: Perlで書かれたジョブ制御スクリプト。
  • 実行: cronによる定期実行。JenkinsからのSSH実行の2系統。

チーム全体でオンプレからクラウドへの移行が進んでいることに加え、サーバー管理の煩わしさからも解放されたいと考え、AWS移行に着手しました。

移行先として設計したアーキテクチャ

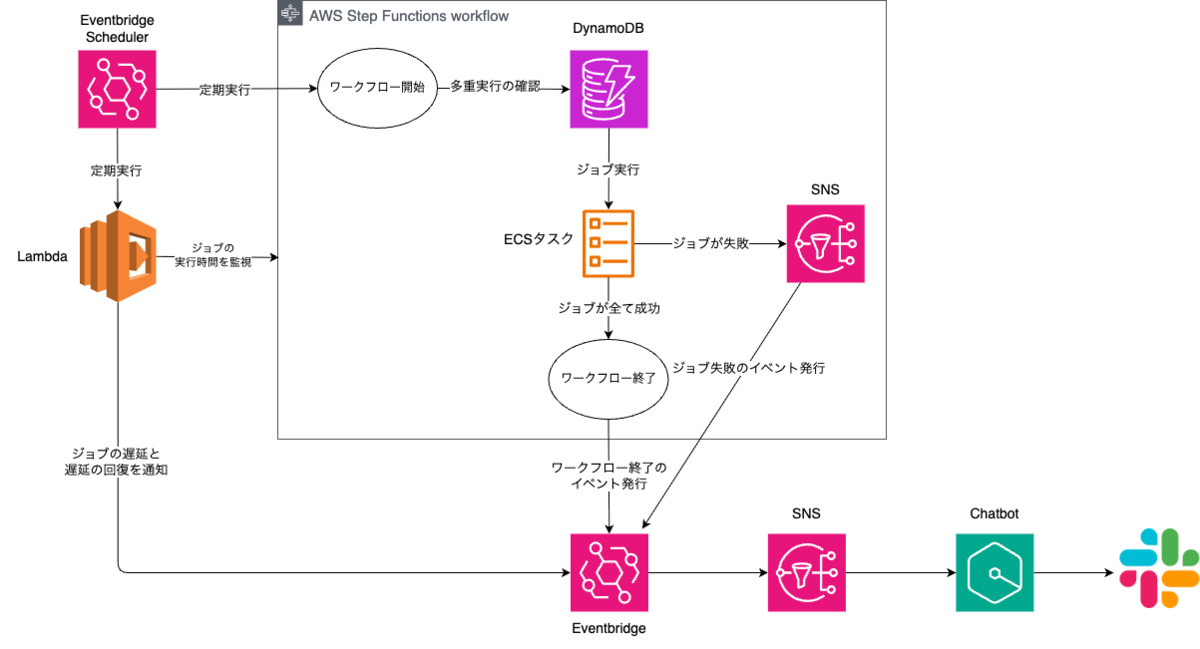
cron + Perlによるジョブ制御をEventBridge Scheduler + Step Functions + ECS(Fargate)で置き換え、ジョブの依存関係をステートマシンで表現する構成を設計しました。現時点では、この構成をテスト環境に構築した段階です。

  • EventBridge Scheduler: cronの置き換え。定期的にステートマシンを起動。
  • Step Functions: Perlのスクリプトが担っていたジョブの依存関係制御。
  • ECS(Fargate): ジョブ本体をワンショットタスクとして実行。
  • DynamoDB: 多重起動防止のロックに利用
    • ※ EventBridge Schedulerのイベント配信が複数回行われる可能性があるため
  • Lambda: ジョブの遅延監視(詳細は後述)
  • SNS → Amazon Q Developer: Slack通知の経路

言語の統一

Ruby、PHP、Perlが混在していましたが、全てRubyに置き換えることにしました。

私たちのチームでは主にRubyを使っていること、PHP、Perlの実行環境を用意したくなかったこと、AI時代に言語の置き換えは容易であることが決め手となりました。

デプロイ方法

今回はecspressoを採用しました。

現状、私たちのチームではデプロイにTerraformを用いることが多いです。しかし、今回の構成では、デプロイ時に必要なアクションはECSのタスク定義を更新するだけです。それだけのためにterraform applyを実行するのは重いと判断しました。

結果として、デプロイが数十秒で完了し、IAM権限の最小化や terraform apply では把握しづらいヘルスチェック失敗の検知も可能になりました。

ジョブの遅延監視

設計中に悩みどころの一つとなったのがジョブの遅延監視です。

オンプレ上で実行されるジョブでは、Perlで書かれたスクリプトが依存関係の制御だけではなく、遅延の監視も行っていました。具体的には以下のような仕様になります。

  • 実行中のジョブが閾値を超えたら、ジョブは止めずにアラートを出す
  • 超えている間は毎時通知する
  • 遅延していたジョブが正常終了したら、「回復」を通知する

この機能は、当初はStep Functionsだけで実現するつもりでした。しかし、仕様を満たす仕組みが作れなかったため、EventBridge Schedulerで1時間ごとに起動するLambda関数を別に用意しました。

この関数はStep Functionsの実行履歴をポーリングし、遅延しているジョブと、遅延から回復したジョブを検知して、SNS経由でSlackに通知します。

構成図

図に起こしたものがこちらです。

AWS構成図

段階移行の計画と、最初の1本で踏んだ落とし穴

オンプレからAWSへの移行対象のジョブを集計したところ、合計で約100本ありました。

これを副作用の有無や他システムとの連携などの観点で10カテゴリに分類し、依存関係がなく副作用の小さいものから移し始めました。

最初の1本の選定

最初に移すジョブには、期限切れのセッションログを削除するバッチを選びました。前後に依存するジョブがなく、かつ何度実行しても問題が無く、テストに最適でした。

まずはこの1本で、EventBridge Scheduler → Step Functions → ECS → DBへの疎通 → Slack通知という一連の流れが通ることを確認し、基盤づくりの足場にしました。

落とし穴

基盤を組んで1本目を動かすなかで、想定していなかったことにいくつもぶつかりました。

特にオンプレサーバーと密結合になっている点については、移行の序盤で最も苦労したポイントです。サーバー側の環境やツールに依存している箇所が次々と出てきて、そのたびにトライ&エラーで解決していきました。

  • オンプレサーバーとの密結合: コンテナに載せて初めて、バッチが「サーバーの環境」に依存して動いていたことに気づきました。環境変数は$HOGEなどサーバーのシェルに定義済みの変数を参照、CSVの出力先もサーバー上の絶対パスに直書き、といった前提が随所にありました。こうした暗黙の前提を、環境変数(SSM Parameter Store)やS3といった明示的な設定へ一つずつ置き換えていく必要がありました。
  • EventBridge Schedulerは多重起動しうる: EventBridge Schedulerの配信は同じ時刻に複数回発火することがあります。ジョブが多重に起動されると二重集計などにつながるため、DynamoDBのロックテーブルで同時に1つしか動かないようにしました。

現状のまとめと今後

現在は、テスト環境にサーバーレスの実行基盤を構築し、依存関係のないジョブを移して疎通確認までを完了した段階です。

cron + Perlによるジョブ制御という仕組みをStep Functionsでワークフローとして表現できる見通しが立ち、ジョブ起動定義・インフラ・テスト環境をTerraform / ecspressoでコード化する流れも作れました。

一方で、他システムとの連携まわりなど、残っている課題は多く、本番環境への移行もこれからです。残りのジョブはカテゴリ単位で順次移行していきます。

チームとしてのこの取り組みは、まだ道半ばです。進捗があれば、またこの場で紹介したいと思います。

We are hiring!

私たちのチームやエンジニアリンググループに少しでも興味を持っていただけましたら、ぜひ採用サイトをご覧ください!

https://career.m3career.com/midcareer/engineer

エンジニアは「開発」から「AIのマネージャー」へ。プロセスを白紙に戻し「10倍」の進化を生み出す組織づくり

こんにちは、エムスリーキャリア株式会社 CTO 兼 CAIOの寺田です。

先日、エンジニアリンググループ全体に向けて「今後のAI活用方針と方向性」について説明しました。今回はその内容をベースに、エムスリーキャリアのエンジニアリンググループが目指している未来についてお話ししたいと思います。

チャットAIによる「1.1倍の改善」からの脱却

現在、多くの開発現場でチャットベースの生成AIツールが導入されています。弊社でも日々の業務で活用が進む一方で、既存の業務フローの延長線上での活用にとどまっており、「圧倒的な生産性向上」に向けては、まだまだ改善の余地があると感じていました。

細かくAIに指示を出したり、AIとやり取りをしてしまうと、結果的に人間がAIをマイクロマネジメントしてしまっています。これでは既存の業務フローの延長線上にある「1.1倍」の改善にしかなりません。

私たちが目指すべきは、既存のプロセスを白紙に戻し、「AIありき」でプロセスを根本から再定義することによる「10倍」の非連続な進化です。

目指すのはAIエージェントによる「自律的な改善サイクル」

最近のAIによる開発では、人間が何度もフィードバックを回す従来の手法から一歩進み、AIエージェント自身が自律的にタスクを解決していくループエンジニアリング的なアプローチがトレンドになっています。

私たちもAIの最適な活用方針を模索する中で、まさにそのアプローチに行き着きました。すでにこれらと同等の仕組みを自社の開発フローに組み込み、実運用に向けて作り込んでいる最中です。

しかし、私たちが目指しているのは、それを単なる「個人の開発環境のアップデート」や「コーディングの効率化」にとどめることではありません。その概念をさらに拡張し、事業KPIの分析から企画立案、そして検証に至る「事業全体の改善サイクル」にまで広げ、組織の仕組みとして定着させることです。

ゴールは、AIエージェントが自律的に状況を判断し、プロダクトの改善ループ(分析 → 企画立案 → 開発 → 効果検証)を自動で回し続ける環境を構築することです。

AIエージェントによる改善サイクル

この「自律的な改善サイクル」は、大きく分けて以下のステップで回っていく想定で、すでに各フェーズにおいて仕組みの構築と実運用が進んでいます。

  1. 分析

    事業KPIを自動で収集・分析し、AIがデータの中からボトルネックや異常値をリアルタイムで抽出します。現在すでに、社内のKPIや営業データをAIに読み込ませ、人間がダッシュボードを見て課題を探すのではなく、AIが自律的に課題を抽出する仕組みが稼働しています。

  2. 企画立案

    過去の事例や市場データなど多角的な情報と、抽出された課題を掛け合わせ、AIが最適な改善策(企画)を立案します。

  3. 開発

    企画を形にするフェーズにおいて、私たちは「ドラフトファースト」で推進しています。従来のように、人間が数時間かけて調査・設計し実装するのではなく、AIエージェントに数行の指示を投げます。AIが数分から十数分で設計・実装・Pull Request作成までを行い、まずは「60%の完成度のドラフト(初稿)」を作り上げます。人間がやるべきことは、そのドラフトを動かして完成度を確認し、要件をブラッシュアップしていくことです。これを仕組み化し全エンジニアが一定水準以上の成果物を担保できるようにしています。

  4. 効果検証

    リリースした機能が事業KPIに与えた影響(A/Bテストの結果など)を自動で集計・評価し、手動でのデータ抽出やレポーティング作業をなくす仕組みにします。

点と点を繋ぎ、シームレスなサイクルへ

現在、これらの仕組みは各フェーズ単体で稼働し、精度を高めているところです。この次は、これらの「点」の仕組みをシームレスに結合させることです。この一連のサイクルが完全に繋がれば、人間の主業務は「作業」から「AIのレビューと最終的な意思決定」へと完全にシフトします。

サイクルを現実のものにするための独自の工夫

この4つのステップからなるサイクルですが、机上の空論ではなく現実の業務で機能させるために、裏側では様々な工夫を仕込んでいます。

例えばその一つが、「組織の暗黙知」の扱いです。社内に蓄積されたドメイン知識や暗黙のコンテキストを、どうAIエージェントに適切に理解させるかなども重要になります。こうした「裏側の仕組み作り」も数多く走っており、それらは今までや1年前のエンジニアの働き方さえも変えていこうとしています。

エンジニアの役割は「開発」から「AIのマネージャー」へ

これまで、エンジニアの役割は4つのステップのうち「開発」フェーズでした。しかし、この自律的な改善サイクルが回り始めると、その常識は大きく変わります。エンジニアは単なる実装作業をAIに任せることで、自ら「分析・企画立案・開発・効果検証」のすべてのプロセスに横断的に入り込み、サイクル全体をドライブしていくことになります。

エンジニアは自らのAIエージェントを「部下」として持ち、タスクを割り振り、レビューする「マネージャー」や「リーダー」としての役割が求められるようになります。また、人間は細かい手順の指定をやめ、「Why / What(目的と枠組み)」の提示と、踏み越えてはいけないガードレールの設計やレビューに徹します。そして、これまで全体のわずかしか割けていなかった、事業成長に直結する「企画」や「意思決定」の時間を増やしていきます。

おわりに

「AIを正しく使えば、開発工数は大幅に削減できる」というのが私の考えです。開発や運用の大部分をAIエージェントによる自律的なサイクルに任せ、人間はビジネスのより深い部分に挑戦していく。そんな全く新しいエンジニア組織を作っています。


私たちのチームやエンジニアリンググループに少しでも興味を持っていただけましたら、ぜひ採用サイトをご覧ください!

https://career.m3career.com/midcareer/engineer

Cloudflare Workers + D1で社内ツールをデプロイした話


こんにちは!エンジニアリングGの松本です。

今回は、Cloudflare Workers + D1を使って社内のJira工数管理ツールを無料でデプロイした話をします。


きっかけ

エムスリーキャリアでは、どの施策にどれほどの工数が掛かったかを算出し、今後の工数改善に繋げる為、Jiraの作業時間ログで管理しています。

しかし、日々の入力を管理するのは少し手間がかかります。

会社のルールでは一日8時間の工数入力が求められるのですが、Jiraにはタイムシート的な横断表示画面がなく、その日どのタスクに何分入力したかが一目でわかりません。

そこで、業務の傍で一目で工数入力や入力状況の確認ができるツール開発を行ってみました。

作りました

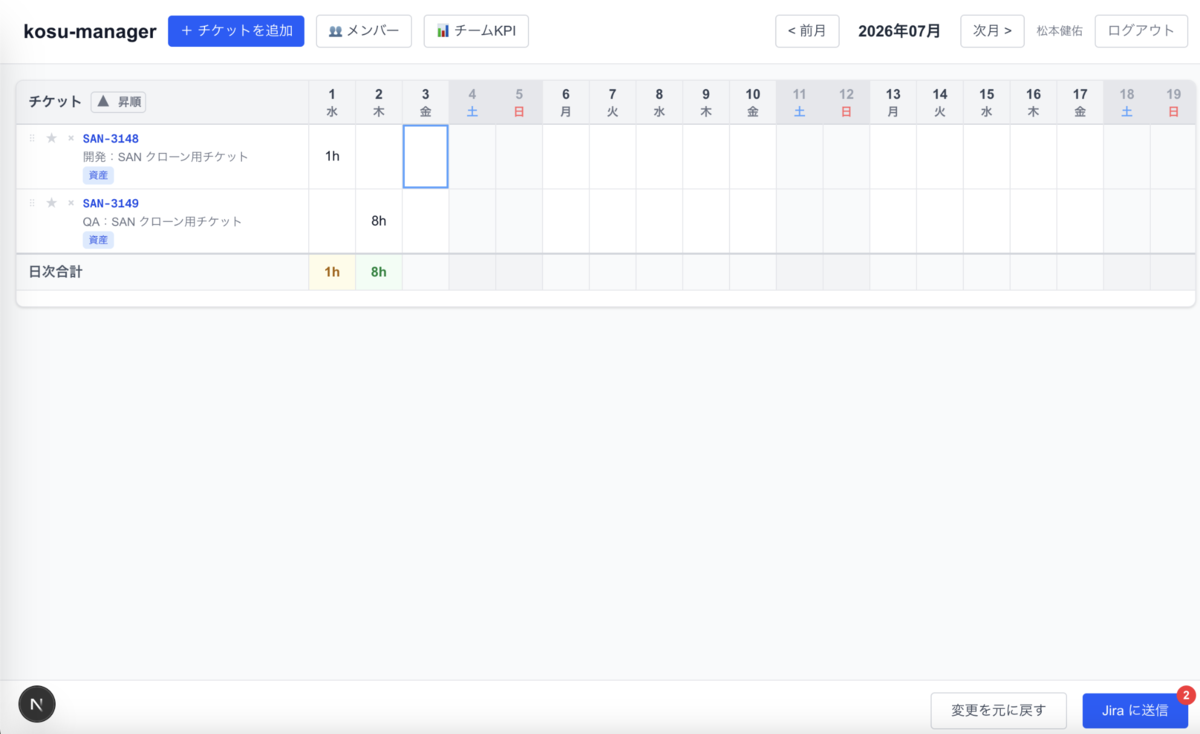
見ての通りですが、Jiraに入力した工数をタイムシート形式で表示・入力できるアプリです。バックエンドではJira APIを叩いて情報を取得しています。

技術スタック

アプリケーション周り

- Next.js

- Tanstack Query

- Tailwind CSS

- Effect-ts

- Drizzle ORM

インフラ周り

- Cloudflare Workers

- Cloudflare D1

- Cloudflare Access

デプロイ

このアプリは最初は個人で使えるようにローカルでサーバーを立てるWebアプリとして開発していたため、比較的手軽にリッチな画面が作れてメジャーなNext.jsを使用していました。

後に、「社内で使えるようにデプロイしてほしい」という要望が出たとき、素直にサーバーを立てようとすると保守やインフラ設定、費用が気になります。

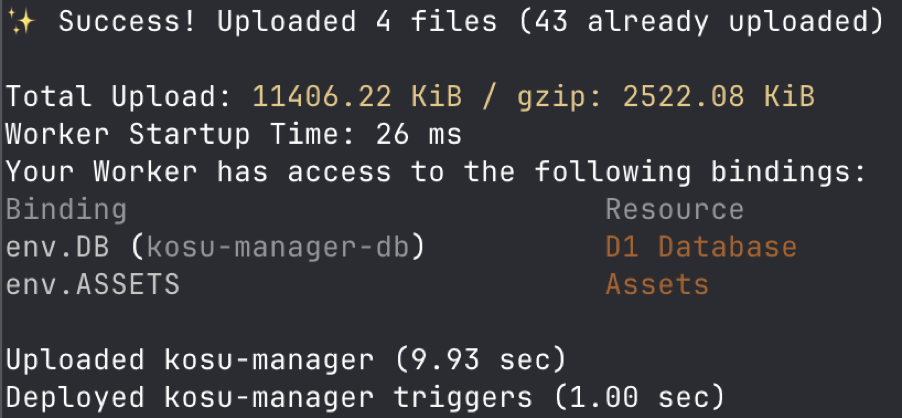
そこでCloudflare WorkersとD1を使えば複雑なインフラ設定なしにサーバレスで保守や費用の負担を最小限にした上で十分運用できると気づき、その方針に切り替えました。

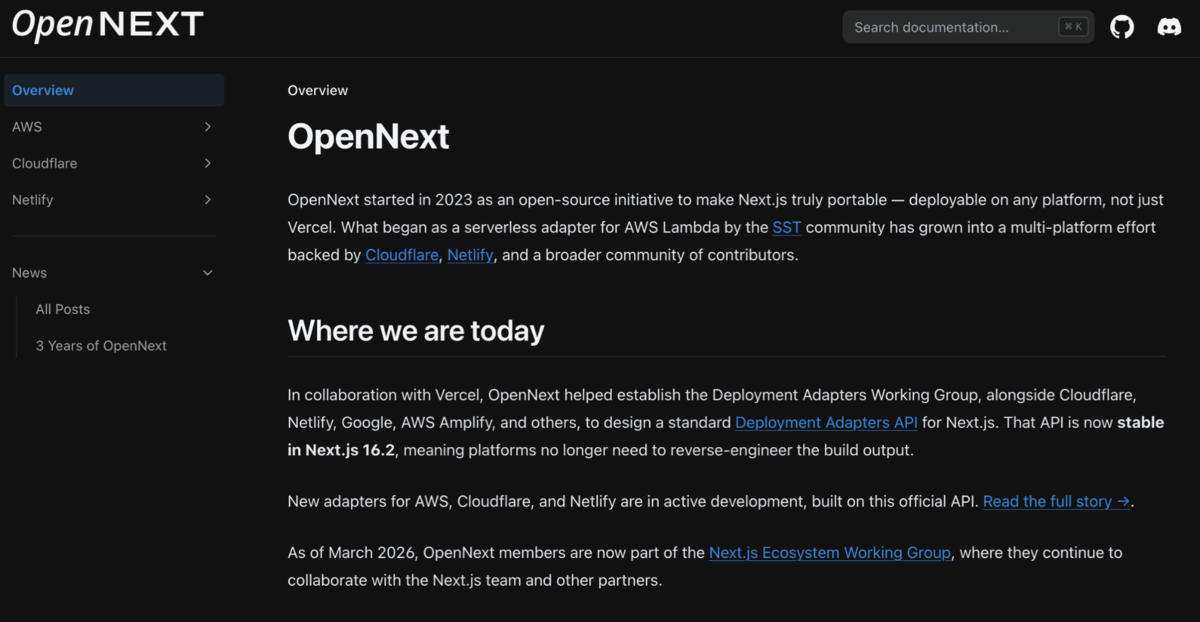
Next.jsはVercelじゃないと難しいという話をよく聞きますが、最近はOpenNextVinext等、Vercel以外の環境へのデプロイ手段が整ってきています。今回はOpenNextを使用してCloudflare Workersにデプロイしましたが、大きな変更なく移行できました。


動作に不安があるかもという声も聞きますが、実際に社内利用する上では十分に実用的であり、無料運用の手軽さを優先しています。

(今回はOpenNextを使用してCloudflare Workersにデプロイ。無料プランのビルドサイズ制限は3MiB(圧縮後)までなので割とギリギリの結果になりました)

(最近Next.js公式がAdapter APIをサポートし始めたおかげでOpenNextも安定版がリリースされました!これからも注目ですね!)

意識したこと

今回のような「Jiraとアプリ内DBの両方にデータを持つ」同期ツールは、実装を誤ると次のような不整合が発生しがちです。

  • Jira側にあるデータがアプリ側に反映されていない(逆のケースも含む)
  • データの同期状態がユーザーから確認できない
  • Jira側に既にデータが入っているのに気づかず上書きしてしまう


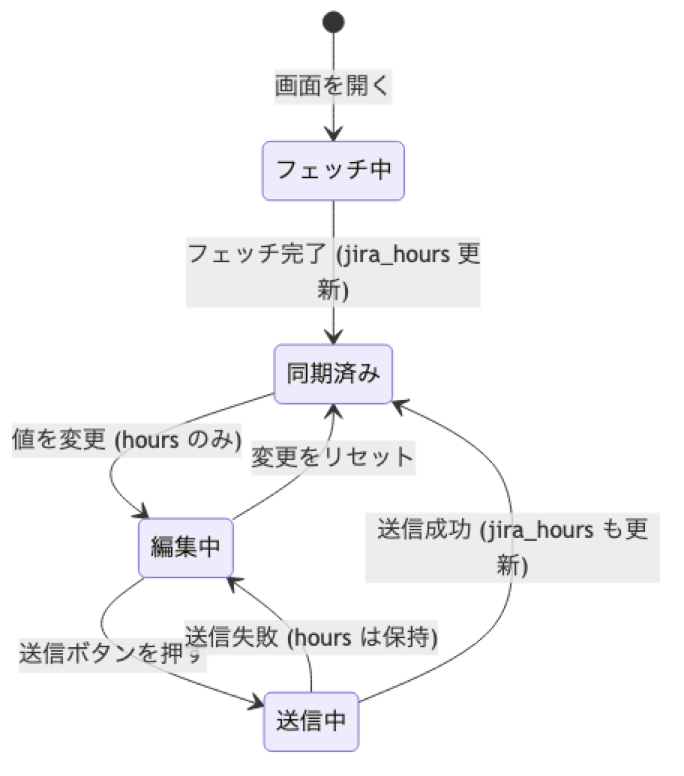
これに対して、DBのレコードには以下の2種類の値を持たせる設計にしました。


フィールド

意味

hours

ユーザーがアプリ上で入力した時間

jira_hours

Jira上の実データのコピー(同期後に更新)

フローはシンプルです。

  1. 取得: 画面表示時にJira APIをフェッチし、jira_hours(Jira上の実データ)を最新化。
  2. 編集: ユーザーが値を変更する際は、ローカル側の hours のみを更新。
  3. 同期: 「送信」ボタン押下時にJira側への書き込みを実行し、成功を確認後に jira_hours を更新。

要するに、UIの操作フロー上で不整合な状態が生まれないよう制御しているということです。

反響

サポートツールとして実装し、自由に利用を促した結果、自主的に13名もの方に利用いただけている状況です!嬉しいですね!

まとめ

 Cloudflare Workers+D1で社内アプリをリリースした記事でした。

 やはりサーバーレスは「小さく作って公開する」ためのハードルをぐっと下げてくれますね。

最後に

今回作成したものは画面構成がリッチでかつ外部連携先とのデータの整合性も考慮しなくてはならないため社内ツールとしてはかなり複雑な内部仕様になっていると思いますが、AIによる強力な設計サポートもあり本業務の傍で完成させることができました。

社内ツールの展開事例、Cloudflare Workers, D1, OpenNext等の活用事例として参考になれば幸いです。


私たちエムスリーキャリアのチームやエンジニアリンググループに少しでも興味を持っていただけましたら、ぜひ下記の採用ページをご覧ください!


https://career.m3career.com/midcareer/engineer


CSチームの近くで働いて気づいた現場にある改善のヒント

はじめに

あるプロダクトの管理画面の改修で、カスタマーサクセスチーム(以下CSチーム)のメンバーにモックの操作イメージを見てもらっていたときのことです。

実際の業務に沿ってこちらで操作しながら見てもらっていると、ふとこんな一言が出てきました。

「この画面、毎回前の画面で確認した薬局の所在地を頭に入れた上で作業しないといけないんですよね...」

ドキュメントを読んでいても、コードを読んでいても、直接話を聞かなければ気づけなかった一言でした。

今回は、入社して間もない時期にCSチームの近くで働いてみたことで得られた気づきと、自分の開発スタイルの変化についての記事になります。


自己紹介

こんにちは。エムスリーキャリアの薬剤師採用支援チームでエンジニアをしている石川です!

昨年12月にエムスリーキャリアに入社し、現在は薬局向けプロダクトの開発を担当しています。

最近は食べたことのない海外料理を食べることにハマっています。少し前に食べたエジプト料理のコシャリがとても美味しかったです!


なぜCSチームの近くで働こうと思ったか

きっかけは大きく2つあります。

1つ目はCSチームからの問い合わせ対応を通じて生まれた疑問です。

問い合わせに対応していると、以下の2点が気になる場面がありました。

・なぜこの事象が起きているのか

・そもそも改善できる余地はないのか

ただ問い合わせを受けて回答するだけでは、その背景や根本原因までは見えないことも多くありました。

2つ目は入社したばかりで、プロダクトが実際にどう使われているのかを知りたかったことです。

コードを読むことはもちろん大事ですが、それだけでは「誰が、どんな流れで、どこに困りながら使っているのか」まではなかなか見えてきません。

それなら、実際に運用されている場に行くのが一番だと思いました。


やったこと

最初から大きなことをしたわけではありません。

まずは次の2つから始めました。

- 週1回、CSチームの席のそばで作業する

- CSチームの定例MTGに参加する


弊社では、フリーアドレス制を導入しており、席はある程度自由に決めることが可能です。

普段はCSチームの方とは業務を行う階が違うため、まずは物理的に距離を近づけるところから始めました。

席にいる間は、自分の作業を進めつつ、CSメンバーが対応している業務を実際に見せてもらったり、雑談の中で困りごとを聞いたりしていました。

「この対応って、実際にはどういうことをしているんですか?」と声をかけて、作業中の画面を見せてもらうこともありました。


CSチーム側の定例MTGにも継続的に参加しました。

そこではプロダクトの利用状況や、導入後のフォロー、リリース前後の周知・問い合わせ対応など、日々の運用に関わる話題が多く扱われていました。

参加を重ねるうちに現在のプロダクトがどのように使われているのか、課題に対してどのような施策が検討されているのかを少しずつキャッチアップできるようになりました。

また、普段の問い合わせを深掘りする中で、実際にどのような事象が発生しているのかを把握できる場面も増え、プロダクト利用の解像度が上がっていきました。


近くで見て気づいたこと

CSチームは、ユーザーからの問い合わせ対応、社内からの依頼対応、データの確認・修正など、幅広い業務を担っています。

近くで見て初めてわかったのは、1件の対応をするだけでも、管理画面や複数のツールを何度も行き来しながら、その都度内容を確認しているということです。

依頼を受けてやり取りしているだけでは、その複雑さまではなかなか見えてきませんでした。

たとえば開発側から見ると「この項目を確認して、この設定を変更する」という単純な作業に見えるものでも、実際には前後の文脈を確認したり別の画面と見比べたりしながら進めていることがあります。

画面上の1クリックの裏に思っていた以上の確認作業がありました。


一番印象に残った出来事

CSチームとの距離が少しずつ近くなってきた頃、管理画面の改修を進めていました。

特定の設定を、これまでより簡単にできるようにする改修です。

せっかくなら実際に使う人に確認してもらおうと思い、CSチームのメンバーにモックの操作イメージを見てもらうことにしました。

実際の業務に沿ってこちらで操作しながら見てもらっていると、冒頭で紹介した一言が出てきました。


「この画面、毎回前の画面の薬局の所在地を頭に入れた上で作業しないといけないんですよね...」


今回の改修とは直接関係のない、何気ない一言でした。

しかしそれはドキュメントにもコードにも書かれていない、実際に作業している人だからこそ気づける困りごとでした。

それまでは、画面遷移後に必要な情報が表示されていなかったため、CSメンバーは前の画面で見た薬局の所在地を覚えたまま作業する必要がありました。

この設定は都道府県によって値が変わるため、薬局の所在地を把握していることは、正確に作業を進めるうえで欠かせません。

そこで、元々の改修に加えて次の画面にも薬局の所在地を表示するようにしました。


小さな変更ですが、実際の業務では「覚えておく」という負荷を減らせる改善です。

後日、CSチームの隣で作業しているときに、直接感謝の言葉をもらえたことも印象に残っています。

話を聞いてみると、一連の改修で月間約10時間の対応工数が削減できたとのことでした。小さな一言から生まれた変更でも、積み重なれば現場の負荷を着実に減らせると実感した出来事でした。

もしCSチームの方に話を聞いていなければ、この改善は生まれなかったと思います。


CSチームの近くで働いて変わったこと

CSチームの近くで働いてみて、実際に運用している人の目線でしか見えないことが多いと実感しました。

CSチームはユーザーと日々接しているため、「実はこういう使い方をしている人が多い」「この操作を想定外にやってしまうケースがある」といった、ユーザーに近い場所でしか聞けない話を持っています。こうした情報は、開発側だけで仕様を考えていてもなかなか出てきません。

継続的に関わる中で、CSチームとの距離も少しずつ縮まりました。以前は問い合わせ対応や依頼のやり取りが中心でしたが、困りごとを相談してもらえる場面が増え、こちらからも気軽に仕様や実際の使われ方を確認しやすくなりました。冒頭のエピソードも、そうした関係性があったからこそ出てきた一言だったと思います。

この体験以降、仕様を検討するときには一度立ち止まってCSチームに確認するようになりました。後から「実際には使いにくかった」と気づくよりも、検討段階で聞いてしまう方がずっと早いと感じています。


今後やっていきたいこと

CSチームの近くで働いたことで、日々の業務の流れが具体的に見えるようになり開発の進め方も少し変わりました。

一方でCSチームの隣で見えたのは、あくまで運用者視点での一側面にとどまります。

次のステップとして実際のプロダクト利用者にユーザーインタビューをさせていただき、ドキュメントにもコードにも現れない困りごとや使われ方を把握していきたいと考えています。

CSチームが捉えている困りごとと、利用者本人が感じている困りごとの両方を知ることで、よりよい改善につなげていきたいと思っています。


おわりに

CSチームの近くで働いてみることは、小さな取り組みだったかもしれません。

それでも実際の業務の流れや、普段の会話の中にある困りごとに触れることで、得られるものは想像以上に大きいと感じました。

今後はCSチームから見える景色だけでなく、実際にプロダクトを利用してくださっている方の声も聞きながら、より良い改善につなげていきたいと考えています!


エムスリーキャリアでは、技術を武器にビジネスやユーザーへの理解を深めながら、より良いサービスづくりに挑戦したいエンジニアを募集しています。

私たちのチームやエンジニアリンググループに少しでも興味を持っていただけましたら、ぜひ採用サイトをご覧ください!

career.m3career.com


RDSのIO天井張り付き問題と次の一手

こんにちはエンジニアチームの山本です。

最近はコテンラジオの龍源さん回を聴いています。抜苦与楽、離苦得楽が耳に残りました。

年始早々にDB障害に遭遇した話をご紹介します。

3行まとめ

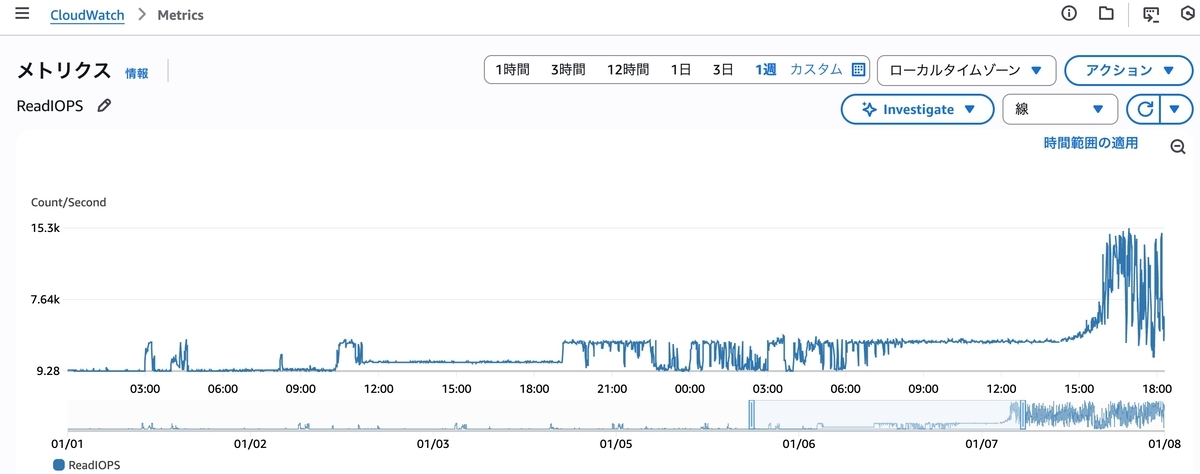
  • RDS for PostgreSQLで大量のディスク読み込み(Read IOPS高負荷)が発生した
  • 論理削除レコードが検索対象に含まれ大量の行アクセスが発生していたのが原因で部分インデックスの導入で解消
  • 発生から解決までのLTを短縮するためAIの活用を検討する

問題の発生と解決まで

突然のIO悪化と枯渇するBurstBalance

1月6日。気持ちよく新年の仕事初めを迎えようとしていた矢先のことでした。

  • 事業側から「特定の画面が表示できず業務に支障が出ている」と連絡
  • DBのRead IOPSが異常に跳ね上がっている
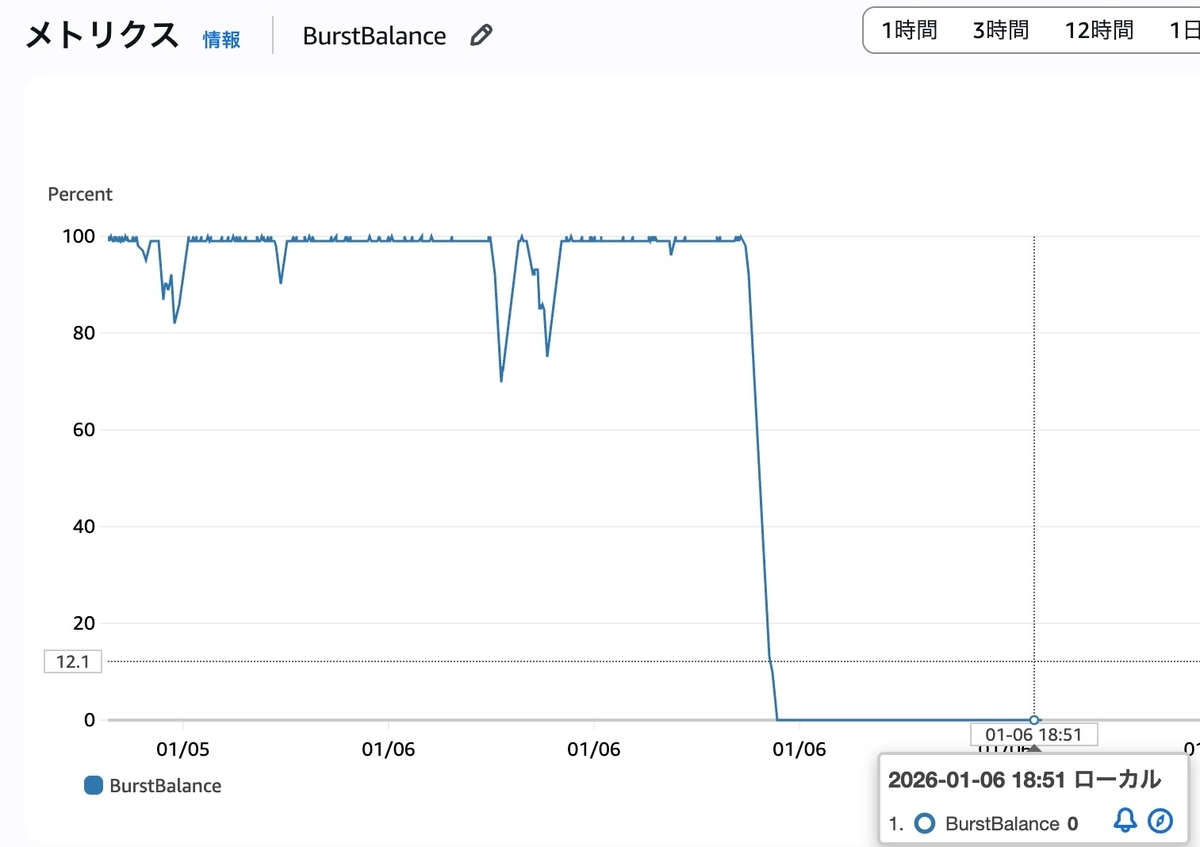
  • DBの BurstBalance が枯渇
  • ディスクタイプは gp2

といった事象が確認されました。

高負荷で張り付くRead IOPS
枯渇したバーストバランス
正月気分が吹き飛びました。

ディスクタイプをgp3にしても解決しなかった

ディスクタイプが gp2 であることを確認した私は、「完全に理解した。gp3 に変更してIOPSの上限を上げれば解決だろう」と早合点しました。

しかし、gp3 へ変更してもIOPSの最大値が上昇し、結局その上限に張り付くだけで問題解決には至りませんでした。

あくまでもIOパフォーマンスの上限が上がっただけで「IOが高くなっている原因を取り除いていない」のでそれはその通りです。

1000万行のテーブルと997万行の論理削除レコード

色々なメトリクスやログに翻弄されながらも、たどり着いたのは「1000万行ある特定のテーブルへのSELECTクエリが異常に遅い」ということでした。

遅いクエリの explain analyze 結果としては

...
Recheck Cond: {条件}
Rows Removed by Index Recheck: 1447586
Filter: (条件)
Rows Removed by Filter: 290967
Heap Blocks: exact=44364 lossy=292651
-> BitmapAnd (cost=239013.33..239013.33 rows=55419 width=0) (actual time=3599.459..3599.461 rows=0 loops=1)
-> Bitmap Index Scan on カラム (cost=0.00..11743.88 rows=468726 width=0) (actual time=72.315..72.315 rows=521373 loops=1)
Index Cond: (条件)
-> Bitmap Index Scan on カラム (cost=0.00..46656.66 rows=1994164 width=0) (actual time=2879.922..2879.922 rows=2044585 loops=1)
Index Cond: (条件)
-> Bitmap Index Scan on カラム (cost=0.00..180612.16 rows=5888480 width=0) (actual time=629.062..629.062 rows=6108671 loops=1)
Index Cond: (条件)
Planning Time: 6.000 ms
Execution Time: 5065.175 ms
...

のような表示が確認されました。

また

show work_mem
4MB

からBitmap Index Scan で作成されるビットマップは最大4MBまでであることもわかりました。

以上より - 1000万行のうち論理削除されていないレコードは3万行 - インデックスの中で作成されたビットマップは約870万行分 - 問題のクエリ実行計画では約200万行程がFilter処理の中で削除されていた - つまり約200万行程のディスク読み込みが発生していた

ことまで辿り着けました。

何が起きたか詳しく

1.ビットマップがメモリに乗り切らなくなる

まずはインデックスから取得するレコードを絞り込んでいきます。 その過程で3つのビットマップ(計870万行分ほど)を work_mem 領域に載せようとします。

-> BitmapAnd (cost=239013.33..239013.33 rows=55419 width=0) (actual time=3599.459..3599.461 rows=0 loops=1)
-> Bitmap Index Scan on カラム (cost=0.00..11743.88 rows=468726 width=0) (actual time=72.315..72.315 rows=521373 loops=1)
Index Cond: (条件)
-> Bitmap Index Scan on カラム (cost=0.00..46656.66 rows=1994164 width=0) (actual time=2879.922..2879.922 rows=2044585 loops=1)
Index Cond: (条件)
-> Bitmap Index Scan on カラム (cost=0.00..180612.16 rows=5888480 width=0) (actual time=629.062..629.062 rows=6108671 loops=1)

ビットマップは「条件に一致する行はディスクのここにあるよ」の集合です。

これが800万行分あるとなるとwork_memの4MBを超えることが容易に想像できます。

2. 曖昧な検索によりディスク読み込みが発生

ビットマップがメモリに乗り切らないと「このディスクブロックのどこかに欲しい行があるよ」。 という曖昧な検索戦略に切り替わります。

Heap Blocks: exact=44364 lossy=292651

より「候補に上がったブロックへディスク読み取り(少なくとも150万行以上は)」が発生したことが推測されます。

部分インデックスの導入で解決

以上より「論理削除されたレコードはビットマップに含めない」を達成するためにインデックスの改善を実施しました。

CREATE INDEX CONCURRENTLY IF NOT EXISTS {インデックス名} 
ON {問題のテーブル} (重いクエリで利用しているカラム DESC)
WHERE delete_timestamp IS NULL;

そもそも「使われるインデックスに論理削除レコードは含めない」という戦略でインデックスを追加したところタイムアウトエラーになっていた画面が表示されるようになり、問題のクエリにかかっていた時間も 5〜6秒ほどから数十msほどまで短縮されました。

そもそもなぜ年始に問題が発生したのか

よりによってなぜ年始になってから極端にディスク読み込みが高負荷で張り付いてしまったのでしょうか。

エビデンスはなく憶測でしかないのですが以下のことが言えると思っています。

work_memに乗り切るかが分水嶺だった

ビットマップがwork_memに乗り切ってくれていればディスクへ「曖昧な走査」を行うことはなかったと思います。

レコードが増えてくる中でメモリから溢れてしまった途端に - 処理に時間がかかり始める - 並列でリクエスト処理が走る分SQLも並列で実行されていく ことで一気にIO悪化が引き起こされたのだと考えています。

反省と学び

「IO上昇の原因調査」よりも「事業影響の解決」を優先するべきだった

初動として「取り急ぎ gp2 から gp3 へ変更する」という暫定対応自体は悪くなかったと思っています。 しかし、その後のアクションとして「なぜIOが高くなっているのか(インフラ寄りの原因)」の調査に固執してしまいました。

一番優先すべきだったのは、「なぜ特定の画面が表示できないのか(アプリケーション・クエリ寄りの原因)」の調査でした。 最終的な原因には同じように辿り着いたかもしれませんが、「高負荷なクエリを1つずつ原因を調べる」のと「問題が顕在化している画面で実行される重いクエリを特定する」のとでは、目の前の問題解決(=ユーザーへの価値提供の復旧)に至る時間は大きく変わっていたはずです。

行指向データベースを理解していなかった

恥ずかしながら行指向データベースがどういうことかをきちんと理解できていませんでした。

今回遅かったクエリについては認識していたはずなのに「絞り込まれたレコードは大した行数じゃないので読み込みも少ない」ような思い込みが、判断を鈍らせていました。

実際には「(ブロックで走査された行数 + インデックスで絞り込まれた行数) * 全カラム分のデータサイズをディスクから読み込む」ということが起きていました。

問題が起きていたクエリが参照しているテーブルにはフリーテキストで比較的大きめなデータ量のカラムも含んでいます。

1行あたり大体 2.5KB で少なくとも150万行のレコードが参照されたと仮定すると少なくみても3GBほどはデータの読み込みが発生しており、数GBのディスク読み込みが発生する画面へのアクセスが複数並列でリクエストが来ることを考えるとReadIOPSが跳ねていた上限まで張り付いていたのも納得できます。

行指向だと「絞り込みの段階で全カラム分のデータ量を読み込んでいる」という意識が足りていませんでした。

タダでは転ばない次の一手

今回の件を経て「問題の発見から解決まで時間がかかった」ことが大きな伸び代に感じています。

時間がかかってしまったのは

  • マイクロサービスな構成故の実態把握難易度の高さ
    • オンプレ、CloudWatch Logs等各所にログが散らかっている
    • メトリクスダッシュボードのようなものもなかった
  • メトリクスに対する理解の浅さ
    • RDS Performance Insights でIO負荷の高いクエリの特定ができた可能性がありましたがAASなどの指標への理解が浅く特定に至れなかった

だと考えています。そこに対して今までだと

  • CloudWatch ダッシュボードの整備
  • 障害から学んだ知見をアウトプットしポストモーテム資料として記録

程度が月並みなアイデアだとは思うのですが、これからは「AIと一緒に仕事できないか」という視点であらゆる業務を見つめ直す必要があると思います。

メンバーからAWS DevOpsを提案いただき、検証してみようという動きになりました。

おわりに

年始早々にシビれる経験をすることができました。

「間違えなければ、成長も創造もない」と藤田あき美さんも話されています。転んだことをプラスに捉えこれからも日々価値を生んでいきます。

エムスリーキャリアでは、技術を武器にビジネスの深掘りに挑戦したいエンジニアを募集中です。興味を持ってくださった方は、ぜひ採用サイトをご覧ください!

career.m3career.com

PlaywrightとGitHub Actionsを用いたE2Eテスト自動実行環境の構築と、リリース頻度向上の取り組み

はじめに

エムスリーキャリアでQAエンジニアをしている宮浦です。
医師採用支援サービスのチームにて、要件定義のレビューからテスト実行まで、プロダクトの品質保証業務全般を担っています。

先日、同じチームのQAエンジニアである山地が、自ら事業課題の解決を起案しリリースまで完遂した記事を公開しましたが、今回は私からもう一つの挑戦についてお話ししたいと思います。

m3career-eng.hatenablog.com


本記事では、手動で行っていたリグレッションテストの負荷を軽減するため、Playwrightを用いたE2Eテストを導入し、さらにGitHub ActionsとSelf-hosted Runnerを組み合わせてCI/CDに組み込んだ事例をご紹介します。この取り組みにより、リリース前確認の工数を削減しつつ、リリース頻度の向上を実現することができました。


背景と課題

私たちのチームでは、機能追加やシステム改善を迅速にユーザーへ届けるため、リリース頻度を高めたいという目標がありました。しかし、そのボトルネックとなっていたのが、リリース前のコンバージョン(CV)確認などに代表されるリグレッションテストです。
毎回手動で画面操作して確認する作業は非常に労力がかかり、ヒューマンエラーのリスクも伴っていました。
そこでまずは、PlaywrightによるE2Eテストの導入を進めることにしました。


第1フェーズ:PlaywrightによるE2Eテストのコード化

まずは手動実行の手間を減らすため、Playwrightを導入し、E2Eテストのコード化に着手しました。


※弊社におけるPlaywright活用の基礎的な取り組みについては、同じくQAエンジニアである川浪が過去に執筆した以下の記事等でもご紹介しています。

m3career-eng.hatenablog.com


テストスクリプトを順次作成していくことで、画面操作による確認作業が大きく減り、確実な品質担保が可能になりました。


しかし、ローカル環境でテストが実行できるようになったとはいえ、「QAエンジニアが手動でテストを起動する」という運用上の手間は残っていました。真の効率向上を目指すためには、パイプラインへの組み込み(自動実行化)が不可欠でした。


第2フェーズ:Self-hosted Runnerの導入

私たちの目標は、「リリース前の検証環境へアプリケーションがデプロイされたタイミングで、自動的にE2Eテストが実行される仕組み」を構築することでした。

ここでインフラ上の課題に直面しました。テスト対象となる社内の検証環境や、外部システムと連携するテスト環境にはIP制限等のアクセス制御がかけられており、GitHub Actionsの標準ランナー(ホステッドランナー)から直接アクセスさせることができませんでした。

この課題を解決するため、セキュアなネットワーク環境内にE2Eテスト専用の実行基盤を構築し、自己ホスト型ランナー(Self-hosted Runner)として運用するアプローチを採用しました。Self-hosted Runnerは、ランナー側からGitHubへジョブを取得しにいく仕組みのため、外部からのアクセス(インバウンド通信)用のポートを開放せずに構築することが可能です。

この構成であれば、社内の厳格なアクセス制御要件を満たしつつ、ランナーが外部からの踏み台にされてしまうようなリスクを抑えた状態で、安全に各検証環境へ接続することが可能です。自前での運用・保守コストは発生しますが、セキュリティ面での統制が効きやすく、総合的な安定性と拡張性に優れていると判断しました。


生成AIとエンジニアの助言を活用したインフラ構築の効率化

専用サーバの構築にあたっては、クラウド上のネットワーク設定やアクセス制御、実行環境の常駐化など、インフラからミドルウェア層の作業が発生します。私の普段の業務領域(QA)からは少し外れる領域もあったため、生成AIを技術的なサポート役として活用しました。
具体的には、以下のような構築プロセスでAIと協力しています。


  • サーバースペックの最適化

AIとの対話を通じて「テスト実行ツールが消費するリソース量」を算出し、同時実行数に応じた必要メモリ要件を導き出すことで、コストとパフォーマンスのバランスが取れたスペックを選定しました。

  • コンテナ環境の権限設定

コンテナ環境を導入する上で必要となる、適切なユーザー権限の付与やセキュリティ設定を行いました。

  • 実行環境の常駐化

自己ホスト型ランナーをバックグラウンドサービスとして、インスタンス上で常時安定稼働させるための手順を構築しました。


一方で、AIの提案をすべてそのまま適用するのではなく、重要な判断についてはチームのエンジニアに相談しています。
社内ネットワークとのセキュアな接続方針や全体のアーキテクチャといった点について的確な助言をもらいながら実装を進めることで、セキュリティリスクを最小限に抑えた確実なインフラ構築を実現しました。
生成AIによる推進力と、チームメンバーの知見を掛け合わせることで、自身の技術スタックを超える環境構築をスムーズに完遂させることができました。


自動実行ワークフローの設計と実装

最終的に完成したGitHub Actionsのワークフローは、以下のような仕様で運用しています。

  1. デプロイ連動の自動実行トリガー
    検証環境へのデプロイ完了をトリガーとして、対象の全E2Eテストが自動的に開始されるように設定しました。これにより、エンジニアがテストの実行操作を意識することなく、シームレスな品質確認が可能なフローを実現しました。

  2. 並列実行と順次実行のハイブリッド設計
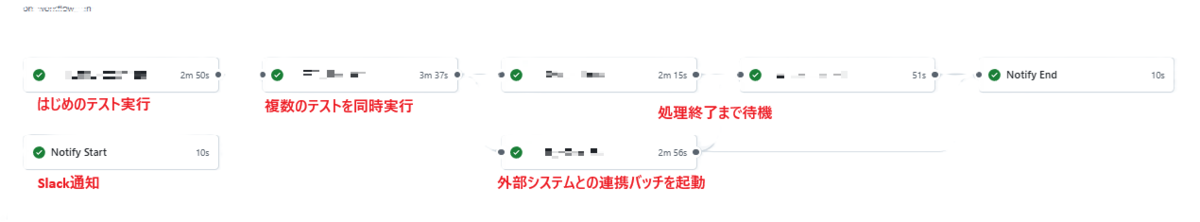
    テスト全体の実行時間を短縮するため、基本的には独立したテストのJobを並列で実行させています。一方で、外部システムとの連携バッチ実行が絡むテストなど、データの競合や順序性が重要なものについては、適切な待機時間を設定し順次実行するよう、Job間の依存関係を細かく定義しました。

    並列実行と順次実行(バッチ待ち等)を組み合わせたGitHub Actionsのワークフロー


  3. 結果通知とArtifactsを用いたトレース
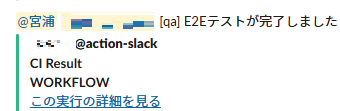
    テストが完了すると、実行時間やステータスがSlackへ自動通知されます。万が一テストが失敗した場合は、Playwrightのレポートファイルや実行時の動画、スクリーンショットがGitHubの「Artifacts」として保存される仕組みにしました。これにより、エラー原因の特定が非常に容易になっています。

    テスト完了時のSlack通知。エラー時は該当レポートも即座に確認可能


成果と今後の展望

Playwrightによるテストコードの実装から始まり、CI/CD環境の構築までを完了させた結果、開発サイクルのスピードは劇的に向上しました。

最大の成果は、「リリース前確認作業の自動化」です。E2Eテスト導入前は月3〜4回程度だったリリース頻度が、CI/CD環境構築後には月7〜8回程度まで増加しました。
これだけリリース頻度が増加したにも関わらず、テストが自動かつ安定して実行されるようになったため、手動でのリグレッションテスト工数をゼロに抑えた状態でのリリースフローを実現できています。

今後は、この実行環境のさらなる安定化とパフォーマンス改善を図るとともに、チーム内でのE2Eテスト適用範囲の拡大、さらには他チームのプロダクトへの横展開を進めていきたいと考えています。


おわりに

プロダクトの価値を素早くユーザーに届けるためには、今回のようなテスト自動化やプラットフォーム整備を通じた認知負荷の低減が欠かせません。QAエンジニアという役割に留まらず、インフラ領域の構築も含めて一気通貫で環境を整備できたことは、非常に良い経験となりました。

エムスリーキャリアでは、こうした自動化技術やAIを積極的に活用し、医療業界の課題解決に共に挑戦していただけるエンジニアを募集しています。少しでも興味を持っていただけましたら、ぜひ下記の採用サイトをご覧ください。

career.m3career.com