テストだけじゃない。いちQAエンジニアが最終承認を得て、事業課題の起案からリリースまで完遂した話

はじめに

エムスリーキャリアでQAを担当している山地です。

現在、私は医療機関向けの医師採用支援サービスを担当しており、QA観点での要件定義レビューからテスト実行まで、プロダクトの品質を担保するための業務を担っています。

「QAエンジニア」と聞くと、作られた仕様書をもとにテストケースを作成し、バグを見つける仕事、というイメージを持たれる方もいらっしゃると思いますが、今回私は「ビジネス課題の発見・起案」から「最終承認の獲得」、そして「要件定義〜リリース」まで、一連の開発プロセスを主導するという初めての経験をしました。


本記事では、いちQAエンジニアである私が、なぜ職掌の枠を超えてビジネス起案を遂行したのか、また、その過程でぶつかった壁・得られた学びについて共有いたします。

「QA=テストする人」という枠組みを超えて働ける、弊社の環境とカルチャーを感じていただけますと幸いです😊


なぜQAがビジネス起案をしたのか?(背景と課題、その打開策)

私が担当しているプロダクトにおいて、「特定の機能を利用していない顧客層(潜在層)へどうアプローチするか」は全社的にも優先度の高い事業課題でした。

そこで、この課題を解決するため、プロダクトの保有データに基づいて顧客ごとにパーソナライズされた訴求UI(新機能)を実装する、という起案を行いました。

しかし、この起案を通常の開発承認フロー(複数の関連部署を経由するルート)に乗せると、どうしてもリードタイムが長期化してしまい、機会損失を生む懸念がありました。


「もっとスピーディーに価値を届けるためにはどうすべきか?」


悩んだ結果、スピードを最優先するため、起案の初期段階から、この施策で直接的に価値を享受する部門の事業責任者を巻き込むアプローチをとることにしました。

具体的には、構想段階で直接相談を持ちかけ、その方々のお力を借りてROI(投資対効果)を算出し、懸念していたリードタイムを大幅に短縮する形で、最終的には事業を統括する決裁者の承認まで持っていくという、QAの枠を大きく超えた動きをとりました。


葛藤とオーナーシップ。「問題 vs 私たち」のマインドセット

上記を言葉にしてみるとスムーズに進んだかのように見えますが、その裏ではどこか「罪悪感」に近い感情との葛藤がありました。

通常、弊社では事業課題の解決や起案はビジネスサイドの主たる職掌であり、そこへQAエンジニアである私が入り込むことに「他のプロフェッショナルの領分を侵しているのではないか」というためらいを感じていました。


そんな葛藤を乗り越える際、心のお守りになったのは「問題 vs 私たち」というマインドセットです。

こちらはソニックガーデンの倉貫義人さんが提唱されている 「対立」ではなく「問題 vs 私たち」の構図をつくる という考え方で、一緒に働くQAの先輩から教わり、私自身も強く影響を受けている言葉です。

※参考: 心理的安全性を生み出す「問題 vs 私たち」と「提案より相談」


「これは誰の仕事か」「誰の顔を立てるべきか」といった組織のサイロ化や遠慮にとらわれるのではなく、「どうすればユーザーと事業に最速で価値を届けられるか」という共通の課題にフォーカスする。そう考えることで、罪悪感を「プロダクトを良くするための推進力(オーナーシップ)」に変換することを試みました。


結果として、開発チーム内にとどまらず、ビジネス側のステークホルダーとのミーティング調整やスケジュール作成など、慣れないガントチャートを引きながら泥臭い調整に奔走することになりましたが、「より良いものを速く作りたい」という想いに(半ば巻き込む形になってしまいましたが🙇‍♀)快く乗ってくださった方々のご協力により、無事に承認まで辿り着くことができました。


QAエンジニアが直面した「ROI・KPI設定」の壁

こうしてスタートしたプロジェクトですが、すぐに未知の壁にぶつかりました。それが「ROI(投資対効果)の算出」です。

普段の業務では「ユーザーの期待を損ねないか」「仕様通りに動くか」「バグがないか」といった品質面にフォーカスしているため、マーケティング視点での「この施策でいくら売上が上がるのか」といった数値を算出する経験が圧倒的に不足していました。


「やりたい」という熱量だけでは、ビジネスとしての承認は下りません。

そこで、ここでも「問題 vs 私たち」のマインドで当該事業のマーケティング担当者に協力を仰ぎ、やりとりを重ねました。


「どの条件を表示したら、顧客は『アクションを起こしたい』と思うか?」

「UIの表示ロジックをどう組めば、クリック率を高められるか?」


ここで役立ったのが、QAとして培ってきた以下のスキルです。

  • 仕様理解の解像度の高さ

  • テスト設計における「因子・水準の整理スキル」

データベース内に保有する各テーブルのカラムの値を分析した上で、ターゲットを絞り込むための複雑な条件(ユーザー属性や利用状況など)を整理し、矛盾や抜け漏れのないパーソナライズロジックを策定することができました。

こうした要件をもとにマーケティング担当者にROIを算出いただいた結果、承認依頼を出すフェーズまでたどり着くことができ、その後、開発承認を獲得するに至りました。


自ら「要件定義」をして気づいた罠

承認を得て、開発スケジュールの目処も順調に進み、いよいよ私の本職である「テストフェーズ」に入ったときのことです。

自分で要件を書き、自分でテスト仕様書を作成してテスト実行したところ、まさかの考慮漏れによる仕様バグが見つかりました。


具体的には、「新設したUIの集計ロジック」と「既存ページ(一覧)の表示ロジック」の乖離です。

新設したUI側では「特定の条件(AとBが一致するなど)を満たすデータ」をシンプルにカウントする要件にしていました。しかし、サイト内の既存ページには、元々『イレギュラーなデータは除外する』といった複雑なネガティブ条件(弾く条件)が実装されていたのです。

そのため、このままでは「新設したUIでは『対象データが存在する』と表示されるのに、既存の一覧ページに遷移すると(複雑な除外条件に引っかかり)1件も表示されない」という、矛盾したユーザー体験を生み出す状態でした。


矛盾や抜け漏れのないパーソナライズロジックを策定することができました

一体…どの口が言っていたのでしょうか…🥺


そこで、「なぜ、要件定義の段階で気づけなかったのか?」について考察しました。


普段、他者が書いた仕様書をレビューする際は、「こういうケースはどうなりますか?(弾かれますか?)」と客観的な視点で気づきやすいものですが、いざ自分が「作りたいもの(ポジティブな要件)」を考える側になると、既存機能との整合性という観点がすっぽ抜けるほど視野が狭くなっていたと感じました。

結果、「弾きたいもの(ネガティブな要件)」の定義が不足していたことに、最終工程になってようやく気づくことになったのです。


「作る視点」と「テストする視点」を一人で切り替えることの難しさ、そして「要件定義の段階で、いかにQAマインド(批判的思考)を発動できるか」の重要性を、身をもって痛感する出来事でした。


おわりに

いくつかの壁や自身の反省点と向き合いながらも、プロジェクトは無事にリリースされ、実際にユーザーからの反応が出始めています🎉


今回の経験を通じて私が最もお伝えしたかったことは、エムスリーキャリアには「QAエンジニアだからここまで」という職能の壁がないということです。

「プロダクトを良くしたい」「ユーザーに価値を届けたい」という想いと、一歩踏み出すオーナーシップがあれば、承認フローを開拓し、組織を巻き込み、事業課題の解決にダイレクトに貢献することもできます。

そのためにはビジネスサイドとの連携および信頼関係の構築、顧客ニーズの理解が不可欠です。ときには修羅の道と感じることもありますが、裁量を持ってエキサイティングな道を選択できる環境はエムスリーキャリアの面白さでもあると感じます。

そして、担当サービスを横断して背中を押してくれるQAチームの存在が、私にとって何よりの心のお守りとなってくれました。


今後はこの経験を活かし、誰もが「問題 vs 私たち」のマインドで越境しやすくなるような、再現性のある仕組みや環境づくりにも挑戦していきたいと考えています。


本記事が、「職能の枠にとらわれず、プロダクトの価値向上にダイレクトに貢献したい」と考えているQAや開発者の方にとって、弊社(とくにQAチーム)のカルチャーを知る一つのきっかけになりましたら幸いです。

私たちの活動に興味を持っていただけた方は、ぜひ下記の採用ページをご覧ください😊

https://career.m3career.com/midcareer/engineer

少人数チームでマルチプロダクトを支える、"頑張りすぎない"プラットフォームエンジニアリング

こんにちは!エムスリーキャリアの薬剤師採用支援チームでチームリーダーを務めている諸岡です。

私たちのチームでは現在、少数精鋭の体制でフェーズや技術スタックの異なる複数のプロダクトを運用・開発しています。限られたリソースでこれらを安定成長させるため、私は頑張りすぎないプラットフォームエンジニアリングというアプローチを採用しています。

認知負荷を制御し、エンジニアリングの醍醐味を取り戻す

認知心理学において、認知負荷は大きく以下の3つに分類されます。

  1. 課題内在性認知負荷: ビジネスロジックやドメインの複雑さなど、解決すべき問題そのものの負荷。
  2. 課題外在性認知負荷: インフラ構成、煩雑なデプロイ手順、ライブラリ更新など、本質に関係のない環境や手順の負荷。
  3. 学習関連認知負荷: 知識を構築し、新しい技術を自分のものにするためのポジティブな認知活動。

以前の記事 公式noteから紐解く、エムスリーキャリアのエンジニア組織が目指す事業貢献の「本質」 - M3Career Techblog でも発信しましたが、弊社には「課題の本質に向き合って事業そのものを伸ばしたい」と考えるエンジニアが多く集まっています。
そして、ユーザーの課題を解き、複雑なドメインモデルを組み上げている瞬間 -つまり課題内在性認知負荷に向き合っている時こそ、エンジニアの創造性が最も発揮されると私は考えています。

私たちのチームでは、課題外在性認知負荷を極限まで減らし、本質的課題にフルコミットできる環境を創る取り組みを行っています。

頑張りすぎないプラットフォームエンジニアリングとは

少人数のチームにおいて、壮大な社内基盤の構築にリソースを割くことは現実的ではありません。本記事における「頑張りすぎない」の定義を、話さないこと・話すこととして改めて整理します。

本記事で話さないこと

  • 基盤構築の具体的な手法: Terraformの書き方や特定のクラウドサービスの構築手順といった技術的な詳細。
  • 重厚な内製ツールの開発: 社内専用ポータル(IDP)の構築や、プラットフォーム自体の巨大なプロダクト化。

本記事で話すこと(実践していること)

  • 認知資源の適正配置: 限られたチームの「脳内メモリ」を、いかにして事業価値に直結する課題へと割り振るか、という組織設計。
  • 解決すべき「外在課題」の選定: 何をプラットフォームエンジニアリングで解決し、何を各エンジニアの裁量として残すべきかという境界線の引き方。
  • チーム内のセルフサービス化: プラットフォームエンジニアリングで得た知見をチームの集合知とするためのプロセス。

私たちが実践しているのは、ツール開発そのものではなく、エンジニアの創造性を最大化するための戦略です。

「外在課題」と「内在課題」の境界線

頑張りすぎないプラットフォームエンジニアリングにおいて最も重要なのは、どこに境界線を引くかという意思決定です。私は以下の基準で、プラットフォームエンジニアリングで解決すべき「外在課題」を選定しています。

  1. 共通性と再現性: 複数のプロダクトで共通して発生し、かつ同じ解決策が適用できるか。(例:CI/CDの基本構成、セキュリティ設定)
  2. ドメイン知識不要な専門性: ビジネスロジックの理解がなくても、技術スタックの知識だけで解決可能か。(例:インフラのコード化、ライブラリのパッチ適用)

逆に、プロダクト独自の複雑なビジネス要件や、それに伴う新たな技術選定などは、プロダクト担当エンジニアが向き合うべき課題内在性認知負荷としてあえて残します。

立ち上げ期におけるチーム内プラットフォームエンジニアの役割

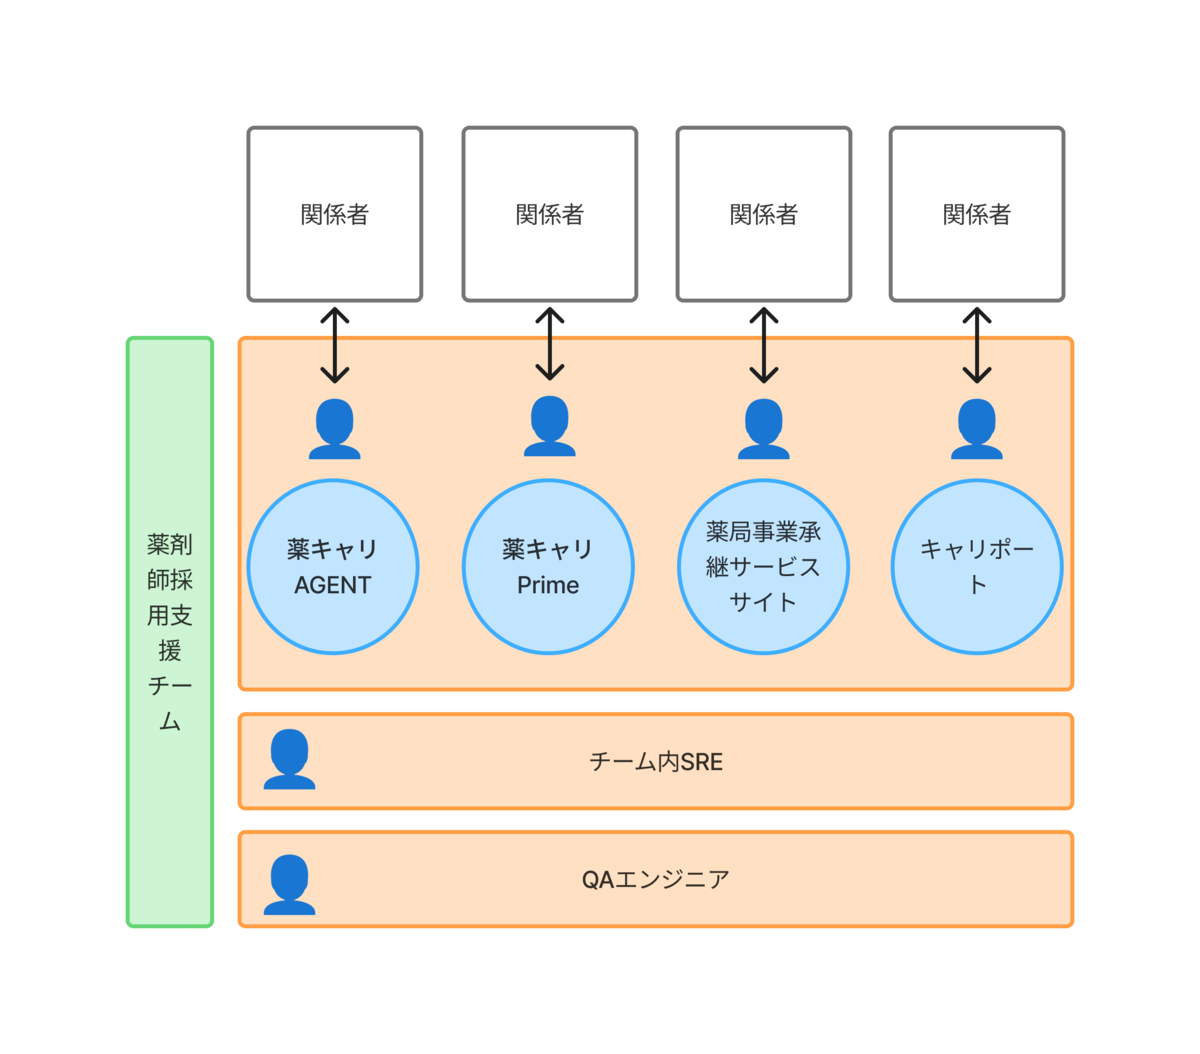
現在のチーム体制は以下の通りです。

現在は立ち上げフェーズであるため、チームリーダーである私がチーム内SREとして横断課題を吸い上げています。
※SRE(サイト信頼性エンジニアリング)は厳密には誤用ですが、活動内容は似ており、社内で既に浸透している役割のため、このように呼称しています。

一般的にチームリーダーが仕事を巻き取ることは、知識がブラックボックス化するサイロ化のアンチパターンとされることがあります。しかしプラットフォームエンジニアリングの立ち上げ期においては、「何が外在課題で、何が内在課題か」の境界線を見極める意思決定を最速で実行する役割が必要です。

私はこの役割を「作業の代行」ではなく、将来的な委任とセルフサービス化のための先行投資と位置づけています。

具体的な活動内容

単に保守を行うのではなく、各エンジニアが迷わず駆け抜けられる舗装された道路(Paved Road)を作るために、以下の2段階で活動しています。

1. 基盤構築:不確実性とメンテナンスコストの排除

まずは、エンジニアの足を止める「外在性負荷」を徹底的に削ぎ落とすための基盤を整えています。

  • レガシーインフラのIaC (Infrastructure as Code) 化: 秘伝のタレ化していた手動設定をTerraformでコード化し、インフラを誰もが触れるツールへ解放。
  • セキュリティの標準化: 各プロダクトで個別に検討が必要だったセキュリティ設定を共通化。プロダクト担当エンジニアが意識せずとも、デフォルトで安全な状態を実現可能に。
  • DevOpsツール設定の標準化: CI/CDパイプラインや、Sentry・Dependabot等の設定を共通化。
  • ライブラリ更新の先行事例: メンテナンスが困難になったライブラリのバージョンアップやリプレースを主導し、モデルケースを作成。

2. チームへのインストール:セルフサービス化への道筋

構築した基盤を「プラットフォームエンジニアだけの持ち物」にせず、チームの集合知に変えていくプロセスです。ここが「サイロ化」を防ぎ、ゴールデンパスを構築するための鍵となります。

  • 課題解決プロセスの相互レビュー: 私が作り上げた設定やIaCのコードは、必ずチームメンバーにレビューを依頼します。「なぜこの構成なのか」を他者に説明し、納得してもらうプロセス自体が、知見の移譲になります。
  • チーム内共有会での発信: 「次はどう触ればいいのか」というコンテキストをチーム全体にインストールします。単なるマニュアル共有ではなく、背景思想を伝えることで、学習関連認知負荷をポジティブに高めています。
  • コードそのものをドキュメントとする: 綺麗に整えられたIaCやCI/CD設定は、それ自体が最高のマニュアルになります。「これを見れば自分でもできそうだ」と思える状態を作ることで、属人化を排したセルフサービス化を促しています。

成果:ビジネスロジックへの集中と、AIと共に自走する現代の開発体験

最大の成果は、プロダクトの年次や経験に関わらず、チーム全員が課題内在性認知負荷、つまり事業を伸ばすための本質的な問いにワクワクしながら取り組めていることです。

特に象徴的だったのは、2025年4月入社の新卒エンジニアの活躍です。彼は外在性負荷に阻害されることなく、入社間もない時期からビジネス議論の最前線に参画しました。

さらに、適切にIaC化されたコードがドキュメントとして機能したことで、彼は現在のコードをコンテキストとしてAIに渡し、AIと壁打ちしながら自力でインフラ設定変更を完遂するという、現代的な自走を見せました。

彼のエントリー プログラムコードは腐るのか? - M3Career Techblog にもある通り、認知負荷がコントロールされた環境だからこそ、早い段階でエンジニアリングの本質に向き合うことが可能になります。

おわりに

プラットフォームエンジニアリングは、事業価値を最大化し、エンジニアが本来の創造性を発揮するための手段です。最初から巨大なシステムを目指すのではなく、チームのフェーズに合わせ、メンバーが最高に面白い課題に集中できる環境を泥臭く整えていくこと。そのプロセスこそが、強いチームを創ると信じています。

エムスリーキャリアでは、技術を武器にビジネスの深掘りに挑戦したいエンジニアを募集中です。興味を持ってくださった方は、ぜひ採用サイトをご覧ください!

career.m3career.com

SalesforceにおけるAI駆動開発の現在地

コーディングエージェントで加速するビジネスロジック開発


はじめに

「このトリガー、誰が書いたんだろう......ロジックが読み解けない」

「フローが複雑すぎて、どの条件分岐がどう動いているのか把握できない」

「緊急の修正依頼が来たけど、影響範囲が怖くて手が止まる」

Salesforce開発に携わるエンジニアなら、一度は誰もが直面する課題ではないでしょうか。宣言型開発(フローやバリデーションルール)とプログラム開発(Apex、LWC)が混在するSalesforceの世界では、ビジネスロジックがどこに実装されているのかを特定するだけでも一苦労です。ましてや、それを「高速に」「品質を保ちながら」変更し続けるとなれば、相当な熟練が求められます。

薬剤師戦略推進チーム所属の前島です。私は現在、Salesforceの開発を中心とした社内システムの開発・改修・運用を担当しています。新卒2年目のルーキーではありますが、AI駆動開発の急速な進化を肌で感じながら、日々の業務に取り組んでいます。本記事では、私がこれまで試行錯誤してきたコーディングエージェントの活用手法と、それによってもたらされた開発プロセスの劇的な変化について共有します。


本記事で得られる価値

本記事を読み終える頃、読者は以下の知見を得ることができます。

得られる知見 具体的な内容
Salesforce開発の複雑性の整理 3層構造と、AI導入時に直面する4つの組織的課題
ツール選択の判断基準 GitHub CopilotとClaude Codeの特性と使い分けの指針
変革の実感(Before/After) 要件矛盾の事前検知、自己修復ループの具体的な効果
AI時代のエンジニア像 コードを書く力から「問う力」へのシフト

[執筆中] .claude/ディレクトリ構成・L1/L2階層化設計のテンプレート、Spec-Driven Development(SDD)の導入手順については、実践編として現在執筆中です。公開次第こちらにリンクを追記します。

「AIを使えば開発が速くなる」という漠然とした期待をお持ちの方も多いと思います。しかし、実際にAIを現場に導入してみると、以下のような壁にぶつかることがほとんどです。

  • 「AIが生成したコードがプロジェクトのアーキテクチャと合わない」
  • 「セキュリティやコンプライアンスの観点から、気軽に使えない」
  • 「AIに何をどう指示すればいいのか、そもそも分からない」

本記事は、これらの課題に対する実践的な解決策を提示します。単なるツール紹介にとどまらず、「なぜその設計が必要なのか」「どのようなプロセスで導入したのか」という文脈を重視しました。本記事は「現状の課題と考察編」です。.claude/の設定テンプレートやSpec-Driven Developmentの実践手順は実践編として別途執筆予定です。(おそらく皆さんが見たいのはこちらですかね?😓)


1. なぜ今、AI駆動開発なのか

1.1 Salesforce開発者が直面する「あるある」ジレンマ

Salesforce開発の現場で、以下のような経験はないでしょうか。

ケース1:トリガーのスパゲッティ

ある顧客レコードの更新時に発火するトリガー。中身を開いてみると、200行を超えるロジックがぎっしりと詰まっています。「このSOQLはどの条件で走るの?」「このDMLは誰が呼んでいるの?」を追うだけで半日が過ぎてしまいます。さらに恐ろしいのは、修正した途端に予期せぬバグが発生することです。

ケース2:フローの迷宮

複雑な条件分岐が組み合わさったフロー。視覚的には理解しやすいはずですが、実際には「このパスは本当に通るの?」を検証するのが困難です。しかも、フローの変更履歴はGitで追跡しにくく、「誰が・なぜ・何を変えたのか」が闇に消えていってしまいます。

ケース3:影響範囲の恐怖

「取引先オブジェクトの項目を一つ追加したい」。シンプルな依頼に見えます。しかし、その項目は20のApexクラス、15のフロー、10のバリデーションルール、そして5のLightningページに関係しているかもしれません。修正そのものより「何が壊れるか」を調べる方が遥かに時間がかかってしまいます。

これらは、Salesforce開発特有の課題というわけではありません。しかし、宣言型開発とプログラム開発が混在するSalesforceのエコシステムでは、これらの課題がより顕著に、より深刻に現れる傾向があります。


1.2 Salesforce開発要素の3層構造

この複雑性の根源を理解するため、Salesforceの開発要素を整理しておきましょう。

Salesforce 開発要素
├── 1. 宣言型開発 (No-Code / Low-Code)
│   ├── データモデル (オブジェクト、項目、リレーション)
│   ├── ユーザインターフェース (Lightning レコードページ、動的アクション)
│   └── ビジネスロジック (Salesforce フロー、承認プロセス)
│
├── 2. プログラム開発 (Pro-Code)
│   ├── バックエンド (Apex クラス、トリガー、非同期処理)
│   ├── フロントエンド (LWC, Visualforce)
│   └── データベース操作 (SOQL, SOSL)
│
└── 3. 連携・運用基盤
    ├── 外部連携 (REST/SOAP API, Platform Events)
    └── 開発ライフサイクル (ALM, Salesforce CLI, メタデータ管理)

宣言型開発は「素早く」「ノンエンジニアでも」実装できる一方、複雑なロジックでは限界があります。プログラム開発は柔軟性が高いですが、高度なスキルと時間を要します。この2つが混在する環境で、ビジネス要件の変化に追従し続けること―それがSalesforceエンジニアに課せられた使命です。


1.3 標準化か、差別化か―SaaSの本質的な問い

Salesforceを導入する企業が直面する最初の、そして最も重要な問いはこれです。「標準機能に合わせるか、独自プロセスを構築するか」この判断は、開発への投資方針を大きく左右します。

判断軸 SaaSに業務を寄せる(標準化) 独自プロセスを維持する(差別化)
業務の種類 バックオフィス(経理、人事、総務) コア事業、顧客接点、独自の製造工程
付加価値の源泉 正確性、スピード、コスト効率 独自のノウハウ、クリエイティビティ
市場の標準 「ベストプラクティス」が存在する 自社独自の商習慣がある
変更の頻度 外部要因(法令等)に合わせて変更 高速にPDCAを繰り返したい

標準化を選択すれば、開発負荷は低いです。しかし、差別化を選択した場合―特に市場の変化に機敏に対応する必要がある場合―エンジニアはこれまで以上のスピードで開発のPDCAを回さなければなりません。ここで鍵となるのが、コーディングエージェントの活用です。


1.4 コーディングエージェントがもたらす「第3の道」

従来、Salesforce開発には2つの道がありました。

  • 道A:熟練エンジニアによる手書き開発―品質は高いが、時間がかかる。属人化のリスクも高いです。
  • 道B:宣言型ツールによる素早い実装―スピードは出るが、複雑な要件では限界があります。

コーディングエージェントは、この2つの間に位置する「第3の道」を切り開きます。

観点 手書き開発 宣言型ツール コーディングエージェント
スピード
複雑要件への対応
一貫性 エンジニア依存 高(インストラクション次第)
学習コスト
属人化リスク 低(ルールを共有化)

コーディングエージェントは、熟練エンジニアの「設計判断」と「コーディング速度」の中間に位置します。適切に設定すれば、誰が使っても同じ品質のコードを、手書きの数倍の速度で生成できるようになります。

ただし、ここで重要な注意点があります。「AIに任せる」ことは「考えなくていい」ことではありません。むしろ、AIを効果的に活用するためには、「なぜその設計が必要なのか」というアーキテクチャの理解が不可欠です。AIが生成したコードが適切かどうかを判断するのは人間であり、その判断には深い洞察が求められます。


2. AI駆動開発を実現する技術スタック

2.1 開発環境の全体像

現在のプロジェクトでは、以下のスタックで開発を支えています。

ツール 役割 エージェントとの関わり
Salesforce 組織 実行環境(本番/Sandbox/Scratch Org) メタデータの取得・デプロイ先
VS Code + Extension 統合開発環境 コード編集、デバッグ、メタデータ操作
Salesforce CLI (SFDX) コマンドラインツール デプロイ、retrieve、テスト実行
sfdx-git-delta 差分抽出ツール 変更セットの効率的な生成
GitHub (Git-flow) ソースコード管理 ブランチ戦略、履歴管理
Atlassian Confluence 公式ドキュメント管理 設計書、議事録(AIからはアクセス不可)

コーディングエージェントが「何を」書くべきかを知るためのソースは、これらのツールに分散しています。特にConfluenceに蓄積されたドメイン知識は、AIから見えない「サイロ」として存在している―これが大きな課題です。


2.2 エンタープライズ導入の必須条件

2.2.1 モデル発給元の統一

当社では、AIモデルの発給元がGCP(Vertex AI)に統一されています。これにより、データガバナンス、監査対応、コスト管理、セキュリティの観点で一元管理が実現されています。

重要なルールとして、各コーディングエージェントやツールの導入は法務審査が必須であり、シャドーAI(無許可でのAIツール利用)は禁止されています。このアプローチにより、開発者が利便性を追求しながらも、組織としてのコンプライアンスが担保されています。

2.2.2 現状の課題:Confluenceのサイロ化

現在、プロジェクトの公式ドキュメントはConfluenceで管理されています。設計書、議事録、意思決定の経緯など、重要なドメイン知識の多くがここに蓄積されています。しかし、ConfluenceはAIから直接アクセスできません(※)。この結果、文脈の欠如、暗黙知の損失、重複作業といった問題が生じています。これが「ドキュメントのサイロ化」問題の核心です。

※Atlassian CLIやAtlassian MCPを利用すれば取得は可能。

2.2.3 解決への構想:Issue駆動開発

MCP導入を待つ以外に、現在構想しているアプローチがあります。GitHub Issuesを「文脈の中央リポジトリ」として位置づけ、設計判断や変更経緯を蓄積していくアプローチです。Confluenceは「読み物」として残しつつ、開発に関する意思決定はIssueに集約することで、AIが追跡可能な履歴を構築します。この構想が実現すれば、MCPの許可状況に関わらず、AIが参照可能な形で文脈を蓄積できるようになります。

※注:これは構想段階であり、実践はまだ始まっていません。


2.3 GitHub Copilot vs Claude Code 選び方の決定打

現在、Salesforce開発において主要なコーディングエージェントとしてGitHub CopilotとClaude Codeの2つがあります。

GitHub Copilot

GitHub Copilotについては、率直に言えば「使いこなせていない感」が強いのが現状です。直面した課題として、インライン補完の限界(アーキテクチャレベルの設計支援や複数ファイルにまたがる実装には活用できていなかった)、インストラクションの肥大化(Copilot-Instructions.mdが大量の情報を詰め込まれた状態)がありました。

しかし、最近のアップデートで状況は変わりつつあります。Copilot CLI・VS Code Copilot ChatではPremium Requestによりリファレンス等の参照が容易になり、Agent Skills(VS Code Insiders)ではClaude CodeやCodexと同様のAgent Skillsが利用可能になりました。

Claude Code

Claude Codeの検証において、特に強力だと感じているのが「エージェント/スキル」の概念と、それらを支えるインストラクション構成の柔軟性です。Subagents(タスク特化型AIペルソナ)、Skills(モデル起動型の能力定義)、Rules(常時参照される軽量ルール)、Docs(必要に応じて参照される詳細ナレッジ)という構成で、AIの振る舞いを詳細に制御できます。

選び方の決定打

結論から言えば「両方使う」が正解です。ただし、使い分けの指針があります。

シーン 推奨ツール 理由
単一ファイルの素早い補完 GitHub Copilot レスポンスが速い
複数ファイルにまたがる実装 Claude Code 整合性を保ちやすい
アーキテクチャレベルの設計 Claude Code Agents/Skillsが強力
コードレビュー Claude Code 専用エージェントで体系的に
日常的なコーディング GitHub Copilot エディタ統合がシームレス

3. 現場で直面した課題と解決アプローチ

AI駆動開発は劇的なスピードアップをもたらしました。しかし、Salesforce特有、あるいは組織特有の「情報の断絶」という課題が浮き彫りになりました。本章では、直面した4つの課題と、それらに対する解決アプローチを整理します。


3.1 ドキュメントのサイロ化による「場当たり的」な分析

【問題】既存のドメイン知識がConfluenceに閉じ込められており、AIは「今あるコード」からの推論に頼らざるを得ません。結果として、本質を突かないリファクタや分析が発生しがちです。

【アプローチ】短期的には人間がコンテキストを補完する運用を継続。中長期的には、Atlassian MCPの許可、Issue駆動開発への移行を構想しています。


3.2 履歴なきGUI改修(突然の「隕石現象」)

【問題】Salesforce特有のGUI(数式項目、バリデーションルール、フロー等)での改修は、Git履歴上ではある日突然現れた「隕石」のように見えます。議論のプロセスがコードベースから切り離されているため、後からAIが意図を汲み取ることが極めて困難です。

【アプローチ】GUIでの設定変更であっても、必ず変更の経緯と意図をGitHub Issuesに紐付ける運用を徹底します(構想段階)。


3.3 ビジネスロジックの分散(コード基盤の乖離)

【問題】ロジックがApex(コード)とフロー/GUI設定(メタデータ)に分散しているため、コードだけを見て判断するとデグレを招くリスクがあります。

【アプローチ】テストによる挙動の確約を構想しています。テストで「コードとGUI設定の間で生じうる不整合」を仕様として明文化し、リグレッションを防ぐ。※これはまだ公式な標準化プロセスではなく、個人的な草の根活動段階です。


3.4 メタデータ定義とエラー通知の非標準化

【問題】Descriptionのフォーマットが不定で更新も続かない、かつバリデーションメッセージもGUI依存(主語抜け)であるため、AIがメタデータから仕様を理解したり、テスト失敗時に原因を特定したりする際のノイズが大きくなっています。

【アプローチ】Descriptionやエラーメッセージのフォーマットを再定義し、標準化を進めています。主語と理由を明記したエラーメッセージ等を維持することで、AIがエラーを読み込み、コードや設定を自動修正させる「自己修復型のフィードバックループ」が極めて正確に回るようになります。


3.5 課題まとめ

カテゴリ 課題 現状 構想・草の根活動
ドキュメント Confluence等への情報のサイロ化 人間がコンテキストを補完 Atlassian MCP、Issue駆動開発
開発プロセス GUI改修によるコンテキストの欠如 特になし Issue-drivenな設定変更履歴
品質保証 ロジックの分散 特になし テストケースでの挙動確約
標準化 メタデータDescription等の形骸化 AIフレンドリーな記述形式の標準化(進行中) ---

4. 実践ストーリー:Before/Afterで見る変革

4.1 ストーリー1:要件の矛盾を事前に検知

【Before】ある機能開発で、以下のような要件を受け取りました。「1回の処理で最大10,000件の取引先を更新できること」「ステータス変更時に通知メールを送信すること」「更新履歴を別オブジェクトに記録すること」。実装を進めていく中でガバナ制限への考慮漏れがあったため、修正が必要になりました。原因は「1件ずつメール送信と履歴記録を行っていた」こと。設計段階で気づけば、実装工数を大きく節約できたはずです。

【After】Spec-Driven Development(SDD)を導入してからは、実装前に技術仕様書(spec)を生成させるようにしました。AIが「この要件では1件ずつメール送信を行うと、ガバナ制限に抵触する恐れがある」と警告を出し、設計段階で問題を発見できました。(※cc-sdd: https://github.com/gotalab/cc-sdd を参照)

段階 Before After
問題発見 実装・テスト後 設計段階
手戻りコスト 大(実装やり直し) 小(仕様修正のみ)
エンジニアの負担 自己批判 AIと一緒に設計を検証

4.2 ストーリー2:自己修復ループ(Self-Healing)

【Before】あるデプロイ作業中のこと。sf project deploy startを実行すると、エラーが発生しました。「ERROR: Invalid field: Some_Field__c on Account」。原因は「ローカル環境に項目定義がない」こと。手動で本番環境から項目定義をretrieveし、メタデータをローカルに取り込み、再度デプロイする必要がありました。これを手動で行うと、都度コマンドを調べ、実行し、結果を確認する必要があります。地味に時間がかかる作業です。

【After】Claude Codeにデプロイを任せると、AIがエラー出力を読み取り、原因を特定し、必要なメタデータを自動でretrieveし、再度デプロイを試行しました。「失敗 → 解析 → 修正 → 再実行」のループが、人間の介在なく回ることで、開発スピードが飛躍的に向上しました。

観点 Before After
対処時間 10-30分(手動) 1-2分(自動)
エンジニアの介入 必須 不要(成功時)
学習コスト コマンドを覚える必要 AIにお任せ

4.3 2つのストーリーから見える共通点

共通するのは、「人間が判断し、AIが実行する」という役割分担です。人間が「どうすべきか」を考え、AIが「どう実現するか」を担います。この協働により、開発者はより価値のある作業に時間を使えるようになりました。


5. AI時代のエンジニア像

5.1 「なんでも作れる」時代の新しい問い

AI駆動開発の進展により、Salesforceエンジニアの役割は大きく変化しています。コーディングエージェントが技術的な実装を高速にこなすようになった今、エンジニアに求められるのは「どう書くか」ではなく「なぜ書くのか」を問う力です。

従来の開発フローでは、要件受領から技術調査、設計、実装、テストと進み、技術調査に多くの時間を費やしていました。AI駆動開発のフローでは、要件受領後、「なぜ必要か」の精査に時間をかけ、AIとの協働による設計、AIによる実装、そしてレビューへと進みます。


5.2 全員がPdMの視点を持つ時代へ

AI駆動開発において、「個人が作りたいもの」は驚くほど簡単に実現できるようになりつつあります。しかし、ここで一度立ち止まる必要があります。その機能は、「みんなが作りたいもの・現場が本当に欲しているもの」と一致しているでしょうか?個人の技術的興味や「作ってみたい」という動機が先行していないでしょうか?

今後のSalesforceエンジニア × コーディングエージェントの開発環境では、メンバーレベルであっても「PdM(プロダクトマネージャー)」のような視点が求められます。優先順位の判断、ステークホルダーの視点、スコープのコントロール、根拠の明確化―これらの能力が重要になります。


5.3 エージェントインフラで再現性を高め、属人化を防止する

この「ディレクションを問い直す」姿勢を組織として持続可能にするために、エージェントインフラの整備が重要な役割を果たします。.claude/rules/.claude/docs/のような仕組みは、単にAIへの指示を効率化するだけではありません。

再現性の担保(誰がエージェントを動かしても同じ品質)、属人化の防止(「あの人しか知らない」暗黙知の共有)、ディレクションの可視化(ルールファイル自体がドキュメントになる)―これらを実現します。


5.4 AI時代に求められる4つの力

AI時代のエンジニアに求められるのは、コードを書く力だけではありません。

  • 全体最適を考える視点:個別の機能ではなく、システム全体としての最適化を意識
  • ステークホルダーの要求を整理する力:依頼の背景や真のニーズを汲み取る
  • アーキテクチャ原則を明文化する力:暗黙知を形式知に変換し、チームで共有
  • 再現性と属人化防止を両立させる設計力:誰がやっても同じ結果になる仕組みづくり

これらはまさに「システムアーキテクト」としての素養であり、AI駆動開発が普及するほど、この視点を持つエンジニアの価値は高まっていくと考えています。


5.5 今後の展望

Claude Code × Devinの併せ技の普及

伴走型エージェント(Claude Code)で設計・仕様を固め、自立型エージェント(Devin)で実装を完結させるフローを、より多くのチーム・プロジェクトで展開していきたいと考えています。
Ruby on Rails 8.1 社内勉強会を実施しました!

こんにちは!エムスリーキャリアで薬剤師向けサービス開発のエンジニアをしている諸岡です。

2025年10月、ついにリリースされた Ruby on Rails 8.1。 rubyonrails.org

新機能が目白押しの今回のアップデートについて、理解を深めて業務への活用イメージを膨らませるべく、エンジニア組織全体で社内勉強会を開催しました。

当日はSlack実況スレッドで「なぜこの機能が導入されたのか?」Railsがいい感じにやってくれる所と、引き続き開発者の技量が試される所は?」といった話題で盛り上がりましたので、その様子をレポートします!

また、デモアプリを実装するにあたって遭遇したActive Job Continuationsの罠と、そこから得た実務的な知見についても共有します。ぜひご覧ください!

勉強会の概要と狙い

今回の勉強会は、単なる知識の共有にとどまらず、「最新技術へのワクワク感を共有し、実務への適用イメージを掴むこと」をゴールに設定しました。

  • 開催形式: オンライン開催、60分間
  • スタイル: ホストがリリースノートや参考記事を読み進めながら、デモアプリを動かす様子を参加者が傍聴する「実況解説スタイル」
  • 参加者: Railsエンジニアを中心に約20名がオンラインで集結

「耳だけ参加(ラジオ感覚)OK」「チャットでのガヤ大歓迎」というカジュアルな雰囲気でスタート。 当日のSlackスレッドは、最終的に50件を超える投稿があり、非常に活発なワイガヤ状態となりました。

ピックアップした3つの目玉機能

60分という限られた時間の中で、特に実務へのインパクトが大きそうな3点に絞って深掘りしました。

1. Markdown Rendering:AI時代の"共通語"

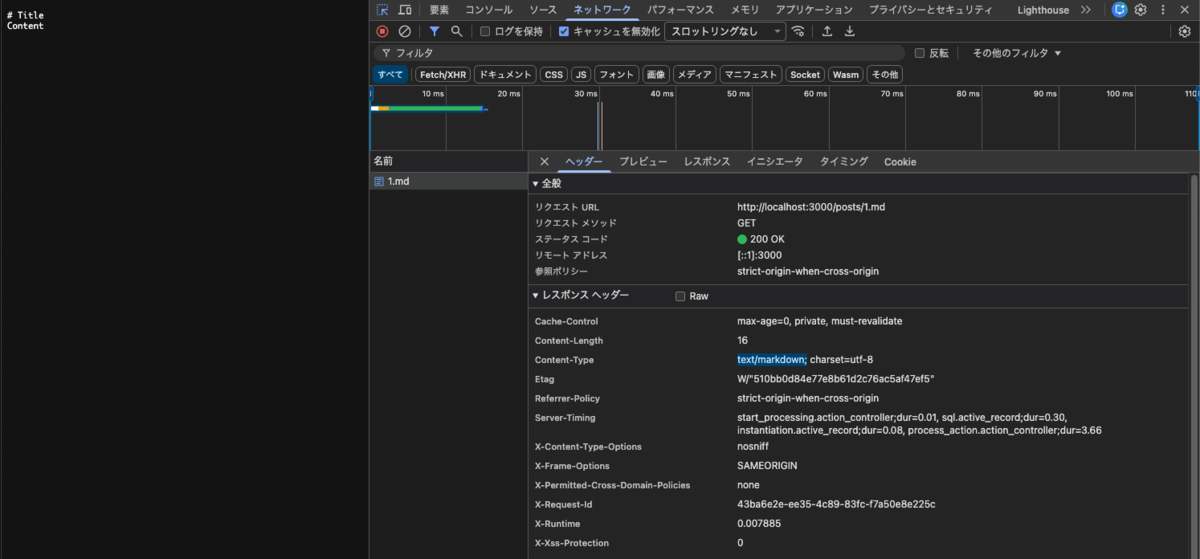
Rails 8.1から、ビューヘルパーによるMarkdownレンダリングが標準サポートされました。

class Post < ApplicationRecord
 def to_markdown
   <<~MARKDOWN
      # #{title}
     #{content}
    MARKDOWN
  end
end

class PostsController < ApplicationController
 def show
  @post = Post.find(params[:id])

   respond_to do |format|
      format.html
      format.md { render markdown: @post }
    end
  end
end

/posts/:id.md にアクセスすると、@post.to_markdownMarkdownとしてレンダリングされる

スレッドでは、リリースノートでも言及されている「リンガ・フランカ(共通語)」という言葉が飛び交いました。

markdown形式は今やAIのリンガフランカ(共通語)となりつつあります。

Ruby on Rails 8.1 リリースノート - Railsガイド

今やMarkdownは人間だけでなく、MCP(Model Context Protocol)サーバーなどを通じたAIとの対話においても不可欠な「共通言語」になりつつあり、Railsが「AI時代の共通言語」をよりネイティブに扱う姿勢を示したアップデートだと感じました。

また、スレッドでは「いずれTOON*1も対応するのかな」といった話題も発生しました。

2. Local CI:”The One Person Framework” と 37signals の思想

次に注目したのが Local CI です。

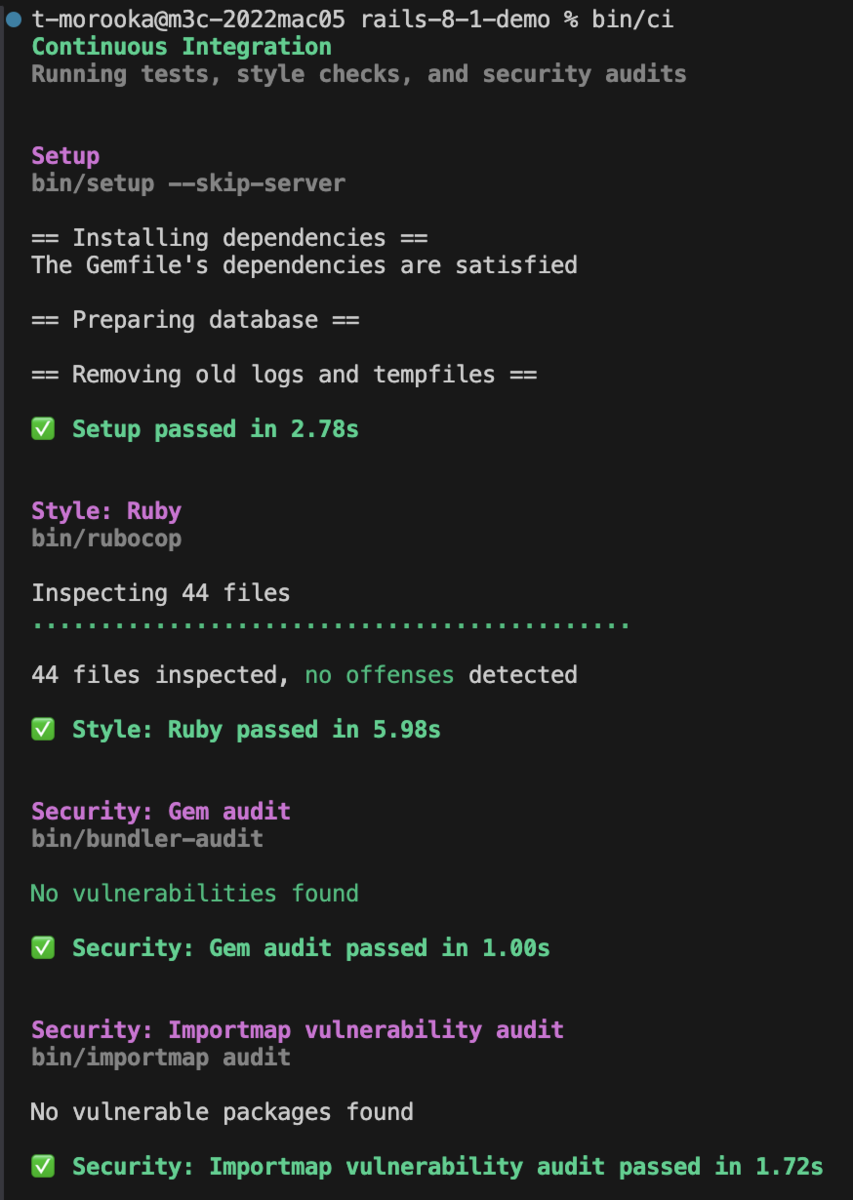
config/ci.rbにCI設定をDSLで記述することで、bin/ciコマンドでCIをローカル環境で実行することができます。

# config/ci.rb
CI.run do
  step "Setup", "bin/setup --skip-server"

  step "Style: Ruby", "bin/rubocop"

  step "Security: Gem audit", "bin/bundler-audit"
  step "Security: Importmap vulnerability audit", "bin/importmap audit"
  step "Security: Brakeman code analysis", "bin/brakeman --quiet --no-pager --exit-on-warn --exit-on-error"

  step "Tests: Rails", "bin/rails test"
  step "Tests: System", "bin/rails test:system"
  step "Tests: Seeds", "env RAILS_ENV=test bin/rails db:seed:replant"
end

bin/ci コマンドでコード解析や自動テストがローカル環境で実行される

「CI環境をクラウドから手元(ローカル)へ」というこの機能については、「DHH*2の思想が強く出ている」「分散と集中の流れの一環ではないか」といった鋭い考察が参加者から寄せられました。

パブリッククラウド一辺倒から、自前で持つプライベートクラウドやオンプレミスへの回帰。37signals*3の掲げる「小さなチーム、大きな仕事」という哲学が、Rails“The One Person Framework” への進化にも色濃く反映されていることを再認識する時間となりました。

参考: Rails 8.1新機能「Local CI」が開発フローを変える!− 高速テスト環境のインパクトと現場での活用法 | 批評家GPTブログ

3. Active Job Continuations:堅牢なジョブ設計への挑戦

最も技術的な深掘りが行われたのが、ジョブの中断と再開をサポートする新機能です。

class DatabaseBackupJob < ApplicationJob
 include ActiveJob::Continuable

 def perform
    # Step 1: Backup database (10 seconds)
    step :backup_database do |step|
      3.times do
        sleep 3
        step.checkpoint!
      end
      sleep 1
    end

    # Step 2: Backup uploaded files (20 seconds)
    step :backup_files do |step|
      6.times do
        sleep 3
        step.checkpoint!
      end
      sleep 2
    end

    # Step 3: Compress backups (30 seconds)
    step :compress_backups do |step|
      10.times do
        sleep 3
        step.checkpoint!
      end
    end

    # Step 4: Upload to cloud storage (20 seconds)
    step :upload_to_cloud do |step|
      6.times do
        sleep 3
        step.checkpoint!
      end
      sleep 2
    end
  end
end

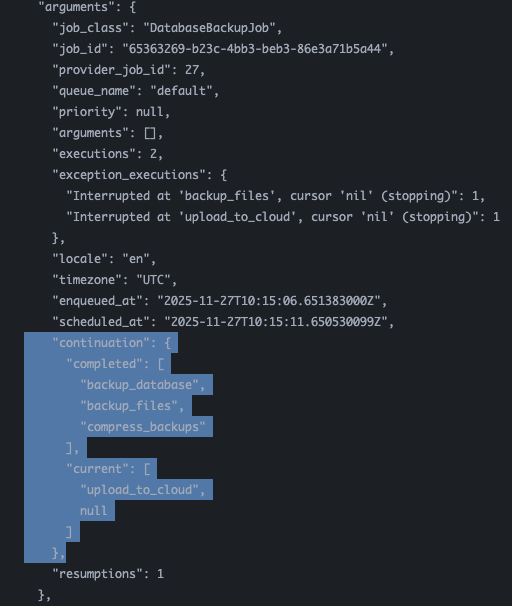
このようにジョブをステップに分割することで、ジョブ実行中のデプロイ作業などで中断・再起動した時、完了済みのステップをスキップして途中から再開します。

upload_to_cloud 実行中に中断した例。実行ステータスがセットされた再開ジョブがキューされている。 Solid Queue + Mission Controlで確認

スレッドでは「前ステップの実行結果を引き継ぐことはできる?」「ステップ間でDBトランザクションは共有される?」などの質問が飛び交いました。

「ステップ毎の冪等性が担保できるよう、自分でしっかり設計する必要がある」という結論に至り、Railsが提供する「レール」の便利さと、エンジニアとしての設計責任のバランスを考える良い機会となりました。

【実録】Active Job Continuations 実装の罠

実は、この勉強会のためにデモアプリを準備していた際、大きな壁にぶつかりました。

長時間ジョブをシミュレートするために sleep 10 を入れたジョブを作成したのですが、どれだけサーバーを強制終了しても「中断・再開」が実現できなかったのです。

def perform
  step :backup_database do
    sleep 10
  end

  # backup_database 完了後に中断しても、backup_filesから再開せずbackup_databaseからやり直し
  step :backup_files do
    sleep 20
  end
end

原因と解決策、得られた知見

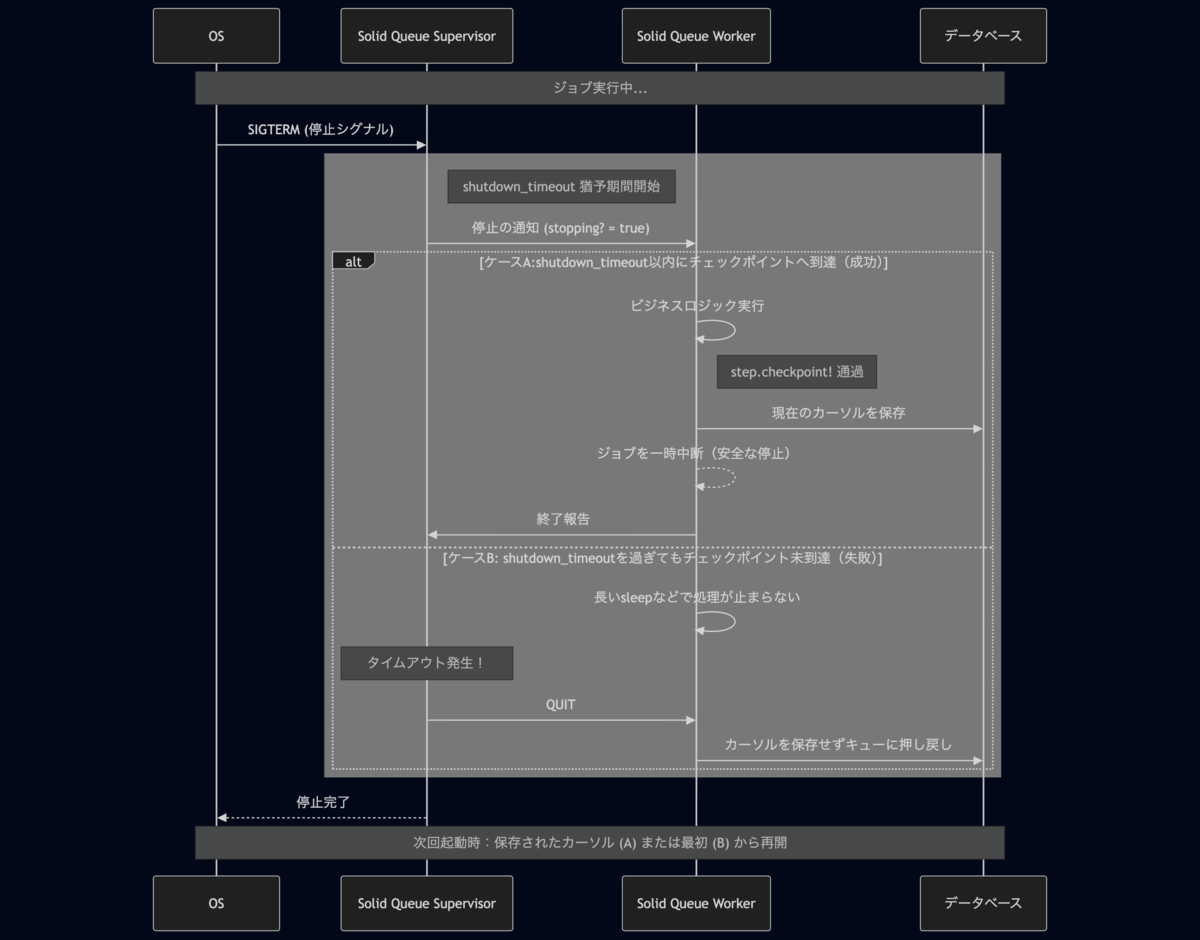
sleep 中は Rubyプロセスが停止するため、Active Job Adapterが発する停止シグナル(stopping?)をジョブ側が検知できないことに原因がありました。シグナルを拾えないため「中断処理」が走らず、結果として単なる実行失敗によるキューへの押し戻し(最初からリトライ)になってしまっていたのです。

Solid Queueの場合、スーパーバイザープロセスがTERMINT信号を受け取ると、ワーカープロセスに停止シグナルを送り、shutdown_timeoutの秒数(デフォルトは5秒)を過ぎても停止していないプロセスをQUITで終了させます。

このshutdown_timeoutよりも長いsleepを行うと、Active Job Continuationsのカーソル保存処理が行われずにワーカーが終了してしまうのです。

最終的に、「3秒 sleep して step.checkpoint! を呼ぶ」をループする構成にすることで、意図した通りの「中断・再開」を実装できました。

def perform
  step :backup_database do |step|
    3.times do
      sleep 3
      step.checkpoint!
    end
    sleep 1
  end

  step :backup_files do |step|
    6.times do
      sleep 3
      step.checkpoint!
    end
    sleep 2
  end
end

今回はあくまでデモアプリ実装における落とし穴でしたが、「各チェックポイントの間隔がshutdown_timeout未満に収まるように設計する」のは実務でも気をつけたいポイントとして知見が得られました。

参加者の声

勉強会後のアンケートでは、「デモアプリがあって挙動がわかりやすかった」Structured Event Reportingについても詳しく知りたくなった」といった前向きなフィードバックをいただきました。

単なるドキュメントの読み上げに止まらない、現場の体温が伝わる知見の共有に繋がったと感じています。

今後も、新しい技術が登場するたびに、こうして手を動かしながら組織全体で学んでいく文化を育んでいきたいと思います。

最後に - We are Hiring!

エムスリーキャリアでは、技術を楽しみ、共に成長していける仲間を募集中です。 本記事のような勉強会や、新しい技術への挑戦に興味がある方は、ぜひ採用ページをご覧ください!

career.m3career.com

*1:Token-Oriented Object Notation

*2:Ruby on Rails の作者である David Heinemeier Hansson 氏の略称

*3:DHH氏が共同創業者・CTOを務めるIT企業

GitHub Copilot Coding Agent を用いた新規プロジェクト開発

はじめに

こんにちは!薬剤師Web開発チームのエンジニアの加藤です。 

弊社では、生成AIの業務活用を積極的に推進しており、最先端のツールに触れながら
開発を進める機会が豊富にあります。

本記事では、弊社でGitHub Copilot Coding Agent(以下、Coding Agent)を用いた開発フロー改善に取り組む中で得られた、新たなプロジェクト開発体験の所感や振り返りなどをご紹介します。

新規プロジェクトでの新しい取り組み

昨年9月頃から新規プロジェクトが発足し、ゼロからプロジェクトを構築することに
なりました。
プロジェクトの技術スタックは、弊社のプロジェクトでは一般的な構成を採用しました。

  • サーバーサイド:Ruby on Rails
  • データベース:PostgreSQL
  • フロントエンド: Hotwire
  • アプリケーション実行環境:Docker

通常、新規プロジェクト発足時は、エンジニアが手動で環境構築を行いますが
今回「どこまでAIに任せて開発を行えるか」という検証を目的として
可能な限りCoding Agentを活用して開発を進行することになりました。

これにより、AIを積極的に活用したプロジェクト開発がスタートしました。

開発初期の環境構築フェーズでの試行錯誤

まず、開発フローを決定する上で、チーム内で以下のフローで開発を行うことを決定しました。

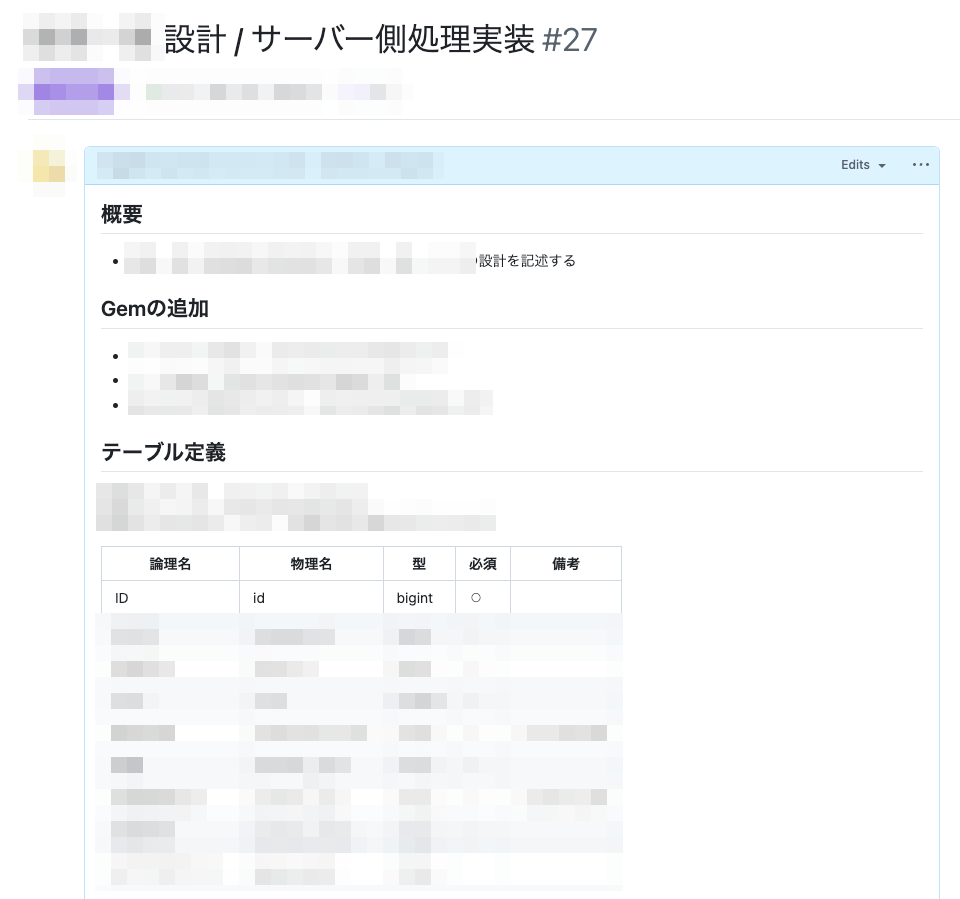
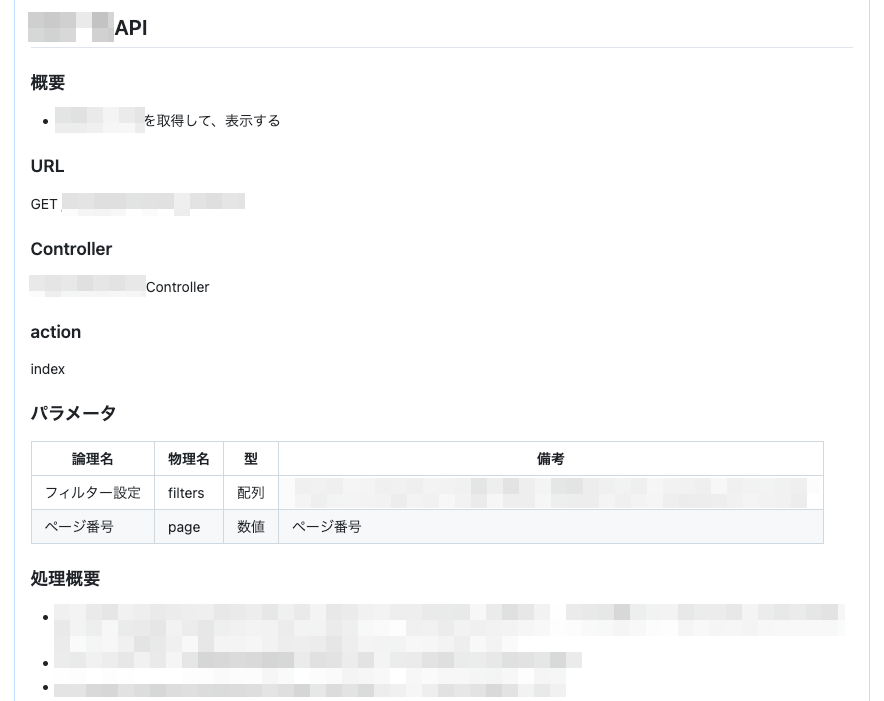
  • GitHubのissueに、担当エンジニアが担当箇所の設計を記述する
  • 他エンジニアがその設計issueのレビューを行い、開発承認をいただく
  • 上記のissueを元に、Coding Agentを用いてコードを生成する
  • 担当エンジニアが生成されたコードを元に、動作確認を行う

上記のフローで開発を進める中で、様々な課題に直面したため、それらを適宜修正していきました。

下記は簡単なCRUD処理を行うページの一例ですが、次のようなissueを作成し、そこからCoding Agentを用いてコード生成を実行しました。


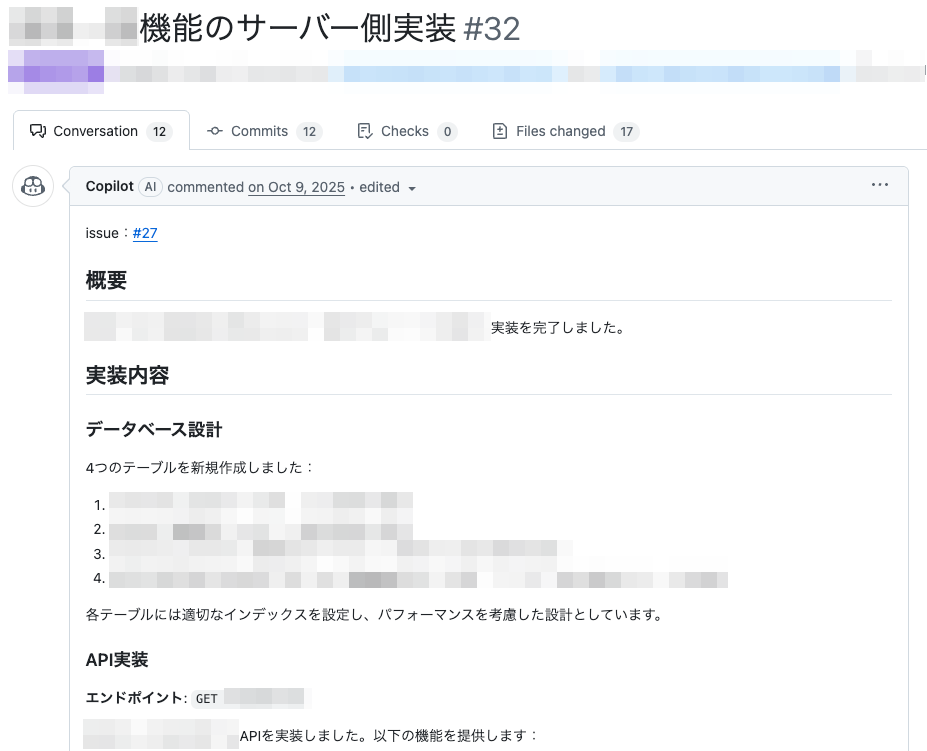
このissueを基にCoding Agentでコード生成を行うと、対象のリポジトリ下記のようなプルリクエストが作成され、担当エンジニアがローカル環境で対象ブランチの動作確認を行った上で、開発を進めました。


◼️ 課題:初期構築フェーズにおける、詳細な仕様記述とプロンプト精度の確保

まず、ローカル環境でdockerを用いて開発環境を構築した際に、以下の点で苦労しました。

  • 採用する技術スタックの資料を基にissueで実装指示を出したが、人に伝える以上の細かい指示出しが必要であった。

ゼロから環境構築を行ったため、Coding Agentに細かな指示を与えないと、想定外の箇所まで修正を行ってしまうことがありました。

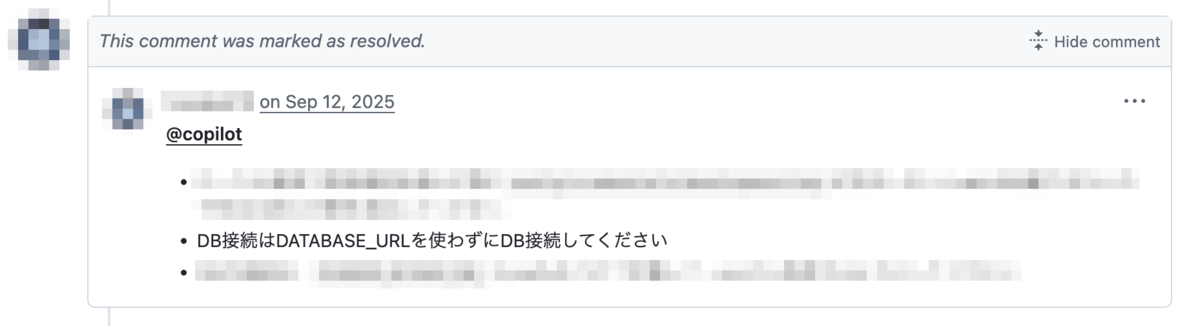
  • プルリクエスト上で修正の指示出しをした際、想定していない部分まで余計に修正が行われることがあった。

修正を指示したところ、意図しない箇所までリファクタリングが行われてしまい、結果としてコードの把握に時間を要し、修正対象外の部分を戻す手戻りが多くなってしまいました。

◼️ 対策:修正指示における、影響範囲外の明示的な言語化

この件に関しては、issueでの詳細な指示の記述をするという対応を行いました。

また、全てCoding Agentに修正させるのではなく、言語化コストと手動修正コストを比較し、後者が低い場合は手動で修正を行う、あるいは、下記のように「〇〇は使用せず、▲▲で対応してください」と、修正指示の際に変更しない部分を明確に記載する対応を取りました。


開発中盤の機能実装とテストコード生成の精度向上

◼️ 課題: 設計の曖昧さによる、仕様と異なるコードの生成

ローカル環境構築が完了し、各担当箇所の作成に取り掛かりました。
ここでもいくつかの課題が発生しました。

  • issueの設計内容で曖昧な箇所があると、生成コードが想定と異なるものが出来上がる

issueの設計内容でロジックを曖昧に記述している箇所など、例えば関数の引数のnullチェックや、APIのクエリパラメータのバリデーションチェックなど、Coding Agentが自動的に解釈して実装してくれます。
しかし、その成果物は、仕様と異なる実装になってしまうこともありました。

  • エンジニアにとって、読みづらいコードが生成される

Rubyのif文の書き方に関しても、unless文が多用される場合があり、エンジニアにとって読みづらい構文になってしまうことがありました。

◼️ 対策:設計と規約の明確化による、生成コードの改善

これらの対策として、issueの設計内容で曖昧な記述を減らし、可能な限り具体的な指示出しを行い、Coding Agentへのプロンプトを正確に記述することが重要でした。

また、コード規約に関しても「copilot-instructions.md」に明確に定めておくことで、全体的にフォーマットが統一された、エンジニアにとっても読みやすいコード生成を行えました。

開発を通して見えてきたAI活用ノウハウと課題

◼️ 気づき:修正指示待ち時間のコスト

開発を進める上で、基本的にコードの修正などもプルリクエスト上で、Coding Agentへ修正指示を出して対応を行いました。

しかし、簡単な修正でも実行完了まで5〜15分程度要するため
数行程度の修正」といった簡単なものはエンジニアが手動で修正した方が早かったり
指示のプロンプトを文章で表現するのが難しい」場合なども、かえって時間を要してしまったため、この辺りの開発プロセスには改善の余地があると感じました。


◼️ 成果: テストコード生成における、飛躍的な開発速度の向上

今回、工数削減効果が最も大きかったのは「テストコードの記述」でした。

ゼロからテストコードを記述する場合、テストケースの考案、テストデータ生成ロジックの記述、そして実際のテストケースの記述に多くの工数が掛かります。

しかし、Coding Agentを用いれば、これらを含めて生成してくれるため
大幅な時間短縮になりました。


◼️ テストコード生成に関しての残課題

ただ、やはり全ておまかせとはいかず、過剰なテストケースが記述されてしまったり
テスト実行に必要なテストデータ生成の記述が足りなかったりと、エンジニアが確認しないといけない項目もありました。

この辺りに関しても、Coding Agentへの指示出しとなるissueの設計プロンプトの改善copilot-instructions.mdの充実が課題だと再度感じました。


最終的な成果と今後の展望

どこまでAIに任せて開発を行えるか」という検証のもと、開発を進めてきましたが、結果として「開発工数の削減に大きく貢献した」と感じています。


◼️
数値的成果

私が担当した箇所の概算ですが
Coding Agentを使わずに実装した場合の想定工数
実際に実装に掛かった工数を比較したところ、約41%程削減することができました。

開発初期は、まだツールを使いこなせていなかったこともあり、余計に時間が掛かってしまった工程もありましたが、開発後半では、Coding Agent を用いた開発にも慣れてきて、かなり開発を効率化できたと実感しました。


◼️ 今後の展望

現在、こちらで紹介した新規プロダクトは春ごろにリリース予定で、引き続き開発中です。

今回、AIを主体とする開発プロジェクトとして、試行錯誤を行いながら開発を進めましたが、結果的には工数削減にも繋がり、AIを用いた開発の様々なノウハウを習得できたと感じています。

ただ、やはりまだまだ完璧に使いこなせているとは言えず、指示出しのプロンプトの精度やcopilot-instructions.mdなどの設定ファイルの充実など、課題は多くあります。

今後もさらなる知見を得て、より効率的な開発を進められるようにしていきたいと考えています。

まとめ

今回、GitHub Copilot Coding Agentを用いた開発プロジェクトの事例を紹介しました。
今後もAI技術は発展していき、私たちの業務には欠かせない存在となっていくでしょう。

技術の発展に遅れを取られないように、引き続き知見やノウハウを蓄積していき
よりよいサービスを開発していけるように努力していこうと思います。

私たちエムスリーキャリアのチームやエンジニアリンググループに少しでも興味を持っていただけましたら、ぜひ下記の採用ページをご覧ください!

https://career.m3career.com/midcareer/engineer

社内AIチャットボット「デジコン君」誕生から進化まで

はじめに

はじめまして。エムスリーキャリア エンジニアリングチームのインフラチームに所属している岡本です。
私たちインフラチームは、会社全体のパソコンやオフィスネットワークの管理、社内ユーザーからのヘルプデスク対応など、いわゆる社内情報システム部門の業務と、エンジニアリンググループで利用している開発環境の管理を担当しています。

本記事では、エムスリーキャリアで利用している「デジコン君」という生成AIを活用した社内向けサービスについてご紹介します。(今回は概要のみの紹介です)

現在のデジコン君は、DifyというノーコードAI開発プラットフォームを利用し、社内外のデータを取得して、社内向けにカスタマイズされたデジタルコンシェルジュサービスです。

デジコン君はエンジニアだけでなく、非エンジニア職の社員も様々なアプリ作成に活用し、当社ビジネスの推進に役立てています。

活用事例については、今後より詳しい方が紹介してくれると信じていますので、今回はデジコン君が元々どのようなシステムだったのかをご紹介したいと思います。


第1章 安全に生成AIを使うために(Googleチャットボット実装)

生成AIが社会で認知され始め、チャット内容の学習データ利用について様々なメディアで報じられていた中、エムスリーキャリアでも社外秘のデータを入力することによる情報漏洩が発生するリスクが懸念されました。そのため、社内ネットワーク上での生成AIシステムへの通信は一時停止されました。

それでも生成AI自体は有用であり、しっかり活用すべきだという考えから、社内で利用可能な生成AIシステムの検討を行い、誕生したのが「デジコン君」……ではなく、「ChatGPTチャットボット【あいちゃん】」です。

あいちゃんはGoogleチャットスペース上で動作するチャットボットで、メンションをするとChatGPTが応答してくれる簡素なものでした。それでも生成AIが使えるようになったことを、当時のエンジニアたちは喜んでくれました。

その後、残念ながらあいちゃんは諸事情により名前を変更することになり、デジコン君という名前がこの時生まれました。


第2章 利用者拡大に向けて(AzureChatへの移行)

その後、あいちゃん改めデジコン君は社内全体にリリースされ、利用が開始されました。当時は生成AIが何なのか分からず、誤った利用方法を取る可能性も考慮し、社員全員が参加するオープンチャットスペースでの利用を行っていました。

利用者は社員の約20分の1程度で、主な利用は文字列変換やエンジニアのSQL文相談でした。利用しない理由を確認したところ、

「オープンスペースだと恥ずかしい」

「そもそも使い方が分からない」

といった声が多く、利用推進のため各部門でアンバサダーを募集し、アンバサダーのいるチャットスペースで展開することで、利用のハードルを下げていきました。

利用者は拡大しましたが、

「オープンスペースは嫌だ」

「チャット履歴が取れない」

といった改善要望は、引き続き多く、Googleチャットでの利用を停止し、AzureChatをベースとしたデジコン君へと移行しました。


第3章 チャット生成AIから社内生成AIプラットフォームへ

AzureChatでの展開後、利用者が目に見えて拡大しました。今まで利用していなかった方も「生成AIってどうやって使ったらいい?」とデジコン君に質問するようになり、その結果、利用拡大へつながる良い流れが生まれました。

その中で、RAGの利用による社内向けデータ活用の需要が高まり、AzureChatからDifyへの切り替えが行われました。

Difyへの切り替えにより、非エンジニアでのアプリ作成や、利用推進活動が活発となり、社内での活用度は格段に上がっていっています。


第4章 今後のデジコン君との付き合い方

あいちゃんから始まったデジコン君は、単なる生成AIチャットボットから社内生成AIプラットフォームへと進化しました。生成AIチャットボット機能は、すでにGemini Enterprise等のエンタープライズ向け生成AIチャット機能に役割が移ったのではないかと思います。

きっとデジコン君も、エムスリーキャリアと同じく、さらなる進化を遂げてくれることでしょう。

わたしたちが現在取り組んでいること

はじめに

こんにちは、Webチームでグループリーダーを担当している本間です。

私が所属するWebチームでは、当社の中では比較的歴史が長く、大規模なシステムの開発を担当しています。具体的には、医師の方や薬剤師の方向けの転職情報サービスなど事業のコアとなるサービスを開発・運用しています。


また、私自身は採用にも関わらせて頂いており、カジュアル面談や一次面接を担当しています。採用的な視点も交えて当社のエンジニアリンググループで取り組んでいることをご紹介できればと思います。

エンジニアリンググループが目指す姿

私たちが目指すのは、単に「システムを作る」ことに留まらず、「BPR」、つまり「Business Process Re-engineeringの実践」と定義しています。

これは、単に頼まれたシステムを作るのではなく、そもそもの業務プロセスにまで踏み込んで、より最適化できないか、この技術を使ったら改善できるのではないか、と提案・実現していく役割を目指しています。

具体的には、業務コンサル的な視点も持ち、ディレクションも行い、そして自分でプログラミングもする。ビジネス課題の発見から、開発、効果測定まで一気通貫で関わることで、事業成長と医療従事者の生産性向上に貢献していくことを目指しています。


大切にしていること

私たちが最も大切にしている価値観は、「事業ファースト」です。

私たちが開発するシステムは、当社のビジネスと、医療従事者のキャリア形成という社会貢献に直結しています。だからこそ、技術的な挑戦を追求する際も

「それは事業を前進させ、ユーザーに確かな価値を提供するか?」

という視点を判断軸に置いています。

日本の医療は医師不足という慢性的な危機に直面しており、私たちの仕事はすべての人々の生活を支える重要な社会インフラを支えることに直結しているからです。

だからこそ、私たちは、技術そのものにこだわるのではなく常に事業ファーストで考えることにこだわっています。

現在取り組んでいること

生成AIの登場は、私たちの開発フローに大きな影響を与えています。私たちはこの変革を好機と捉え、開発プロセスを抜本的に変えようとしています。

単純な作業はAIをフルに活用し、エンジニアは事業を伸ばすためのアイデア創出や改善案の質を向上させることへ、より注力していく方針です。これからのサイト開発では、単なる機能改善に留まらず、「ユーザー体験の再構築」を目指したいと思っています。

私たちは、「まずはシステムやAIを前提とした業務フローを構築し、そこに専門性を持つ社員が介在することで、機械にはできない価値を創出する」。このようにAIと人間がベストな形で共存できる環境を目指し、開発プロセスそのものを見直しています。

AIと共存するプロセスへ

私たちは、AIとの共存を前提に、エンジニアの役割を大きく変えようとしています。

・実装はAIとの協業へ

単純な作業はAIをフルに活用し、最新技術を活用して抜本的な効率化と改善を実施していきます。

・役割をより上流へシフト

コードを書く速さや量から、より上流の能力へとシフトします。事業を伸ばすためのアイデア創出や改善案の質の向上へ注力していきます。

・業務フローの主体をAIへ

AIが業務フローの主体となり、人間がそのアウトプットを確認します。その中で、人間にしかできないコミュニケーションの価値を強化していきます。

どんな方と一緒に働きたいか

私たちエムスリーキャリアのエンジニアリンググループでは、コーディングのスキルも大切ですが、以下のような価値観をお持ちの方を歓迎しています。

1.事業への当事者意識

依頼された仕様を満たすだけでなく、「その仕様は本当に最善か?」「技術で業務プロセスそのものを変えられないか?」と、業務の深い部分まで踏み込んで考えたい方。

医療従事者の生産性向上という社会貢献に、技術を通じてコミットしたい方。

2.変化への適応力と学習意欲

AIの進化により、エンジニアの役割は日々変化しています。「コードを書く量」ではなく「事業を伸ばすアイデアの質」で勝負する新しい環境を楽しみたい方。

最新技術の活用に積極的に挑戦し、自身のスキルを上流へシフトさせたい方。

3.コミュニケーションとチームワーク

AIが業務の主体となる環境では、人間同士のコミュニケーションの質がより重要になります。事業部門や企画担当者と協力し、課題解決を主導していきたい方。


おわりに

今回は、私たちのエンジニアリングの価値観についてご紹介しました。

エムスリーキャリアのエンジニアリンググループでは、「コードを書く」エンジニアから、「事業と業務プロセスをデザインする」エンジニアへと進化を遂げようとしています。

もし、この変革期を一緒に楽しみ、医療×ITという成長分野で社会貢献とキャリアアップを両立したいと、ご興味をいただけましたら、ぜひ一度カジュアル面談を受けてみてください。

エムスリーキャリアでは、仲間を募集しております。

career.m3career.com